day10-Redis 面试篇
day10-Redis 面试篇
经过前几天的学习,大家已经掌握了微服务相关技术的实际应用,能够应对企业开发的要求了。不过大家都知道在 IT 领域往往都是面试造火箭,实际工作拧螺丝。
为了更好的应对面试,让大家能拿到更高的 offer,我们接下来就讲讲“造火箭”的事情。
接下来的内容主要包括以下几方面:
Redis 高级:
- Redis 主从
- Redis 哨兵
- Redis 分片集群
- Redis 数据结构
- Redis 内存回收
- Redis 缓存一致性
微服务高级:
- Eureka 和 Nacos 对比
- Ribbon 和 SpringCloudLoadBalancer
- Hystix 和 Sentinel
- 限流算法
1.Redis 主从
单节点 Redis 的并发能力是有上限的,要进一步提高 Redis 的并发能力,就需要搭建主从集群,实现读写分离。
1.1.主从集群结构
下图就是一个简单的 Redis 主从集群结构:

如图所示,集群中有一个 master 节点、两个 slave 节点(现在叫 replica)。当我们通过 Redis 的 Java 客户端访问主从集群时,应该做好路由:
- 如果是写操作,应该访问 master 节点,master 会自动将数据同步给两个 slave 节点
- 如果是读操作,建议访问各个 slave 节点,从而分担并发压力
1.2.搭建主从集群
我们会在同一个虚拟机中利用 3 个 Docker 容器来搭建主从集群,容器信息如下:
| ##### 容器名 | ##### 角色 | ##### IP | ##### 映射****端口 |
|---|---|---|---|
| r1 | master | 192.168.150.101 | 7001 |
| r2 | slave | 192.168.150.101 | 7002 |
| r3 | slave | 192.168.150.101 | 7003 |
1.2.1.启动多个 Redis 实例
我们利用课前资料提供的 docker-compose 文件来构建主从集群:

文件内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003"]
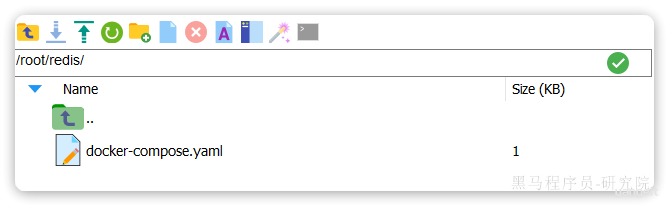
将其上传至虚拟机的 /root/redis 目录下:
执行命令,运行集群:
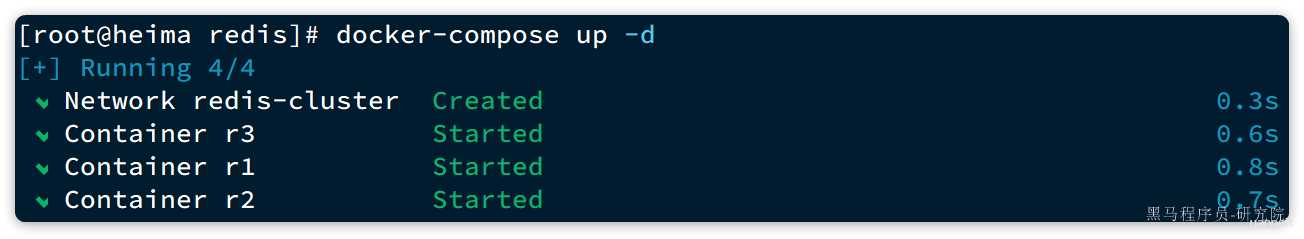
docker compose up -d
结果:
查看 docker 容器,发现都正常启动了:
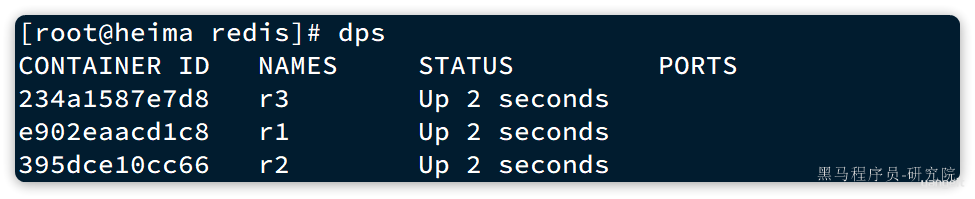
由于采用的是 host 模式,我们看不到端口映射。不过能直接在宿主机通过 ps 命令查看到 Redis 进程:

1.2.2.建立集群
虽然我们启动了 3 个 Redis 实例,但是它们并没有形成主从关系。我们需要通过命令来配置主从关系:
# Redis5.0以前
slaveof <masterip> <masterport>
# Redis5.0以后
replicaof <masterip> <masterport>
有临时和永久两种模式:
- 永久生效:在 redis.conf 文件中利用
slaveof命令指定master节点 - 临时生效:直接利用 redis-cli 控制台输入
slaveof命令,指定master节点
我们测试临时模式,首先连接 r2,让其以 r1 为 master
# 连接r2
docker exec -it r2 redis-cli -p 7002
# 认r1主,也就是7001
slaveof 192.168.150.101 7001
然后连接 r3,让其以 r1 为 master
# 连接r3
docker exec -it r3 redis-cli -p 7003
# 认r1主,也就是7001
slaveof 192.168.150.101 7001
然后连接 r1,查看集群状态:
# 连接r1
docker exec -it r1 redis-cli -p 7001
# 查看集群状态
info replication
结果如下:
127.0.0.1:7001> info replication
# Replication
role:master
connected_slaves:2
slave0:ip=192.168.150.101,port=7002,state=online,offset=140,lag=1
slave1:ip=192.168.150.101,port=7003,state=online,offset=140,lag=1
master_failover_state:no-failover
master_replid:16d90568498908b322178ca12078114e6c518b86
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:140
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:140
可以看到,当前节点 r1:7001 的角色是 master,有两个 slave 与其连接:
slave0:port是7002,也就是r2节点slave1:port是7003,也就是r3节点
1.2.3.测试
依次在 r1、r2、r3 节点上执行下面命令:
set num 123

get num
你会发现,只有在 r1 这个节点上可以执行 set 命令(写操作),其它两个节点只能执行 get 命令(读操作)。也就是说读写操作已经分离了。
1.3.主从同步原理
在刚才的主从测试中,我们发现 r1 上写入 Redis 的数据,在 r2 和 r3 上也能看到,这说明主从之间确实完成了数据同步。
那么这个同步是如何完成的呢?
1.3.1.全量同步
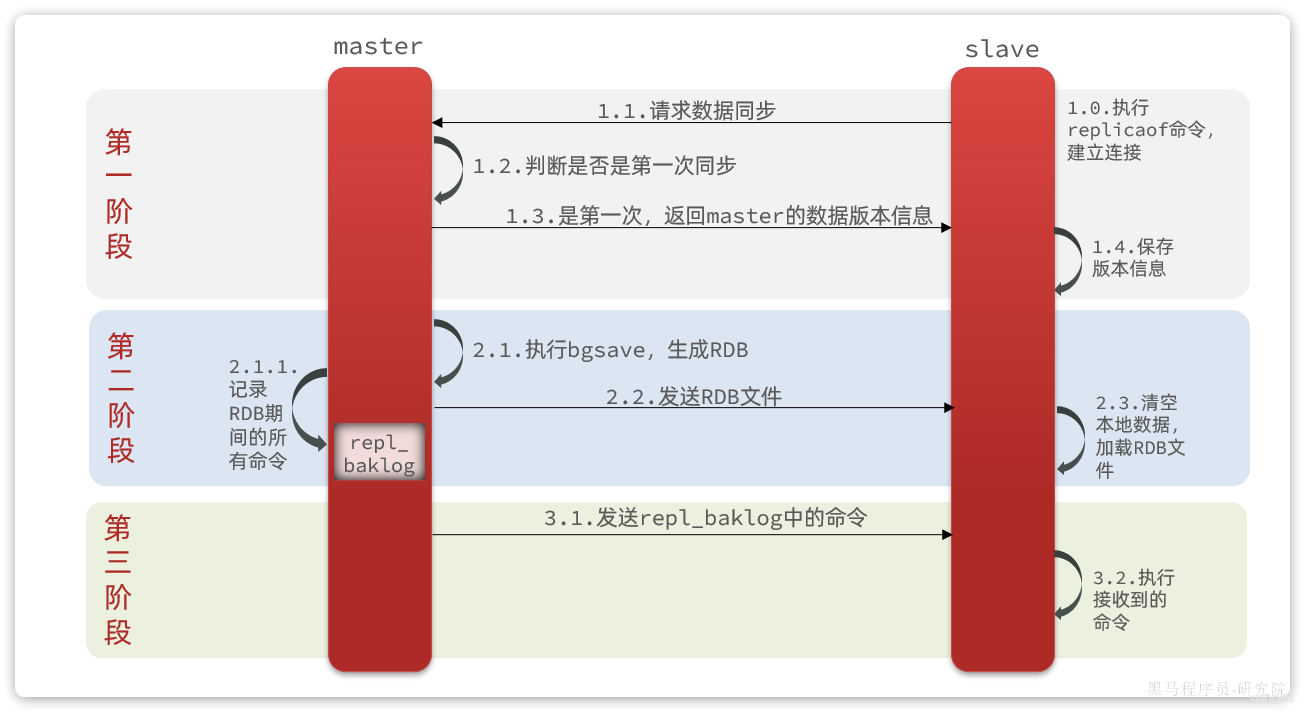
主从第一次建立连接时,会执行全量同步,将 master 节点的所有数据都拷贝给 slave 节点,流程:
这里有一个问题,master 如何得知 salve 是否是第一次来同步呢??
有几个概念,可以作为判断依据:
- Replication Id:简称
replid,是数据集的标记,replid 一致则是同一数据集。每个master都有唯一的replid,slave则会继承master节点的replid - offset:偏移量,随着记录在
repl_baklog中的数据增多而逐渐增大。slave完成同步时也会记录当前同步的offset。如果slave的offset小于master的offset,说明slave数据落后于master,需要更新。
因此 slave 做数据同步,必须向 master 声明自己的 replication id 和 offset,master 才可以判断到底需要同步哪些数据。
由于我们在执行 slaveof 命令之前,所有 redis 节点都是 master,有自己的 replid 和 offset。
当我们第一次执行 slaveof 命令,与 master 建立主从关系时,发送的 replid 和 offset 是自己的,与 master 肯定不一致。
master 判断发现 slave 发送来的 replid 与自己的不一致,说明这是一个全新的 slave,就知道要做全量同步了。
master 会将自己的 replid 和 offset 都发送给这个 slave,slave 保存这些信息到本地。自此以后 slave 的 replid 就与 master 一致了。
因此,master****判断一个节点是否是第一次同步的依据,就是看 replid 是否一致。流程如图:

完整流程描述:
slave节点请求增量同步master节点判断replid,发现不一致,拒绝增量同步master将完整内存数据生成RDB,发送RDB到slaveslave清空本地数据,加载master的RDBmaster将RDB期间的命令记录在repl_baklog,并持续将 log 中的命令发送给slaveslave执行接收到的命令,保持与master之间的同步
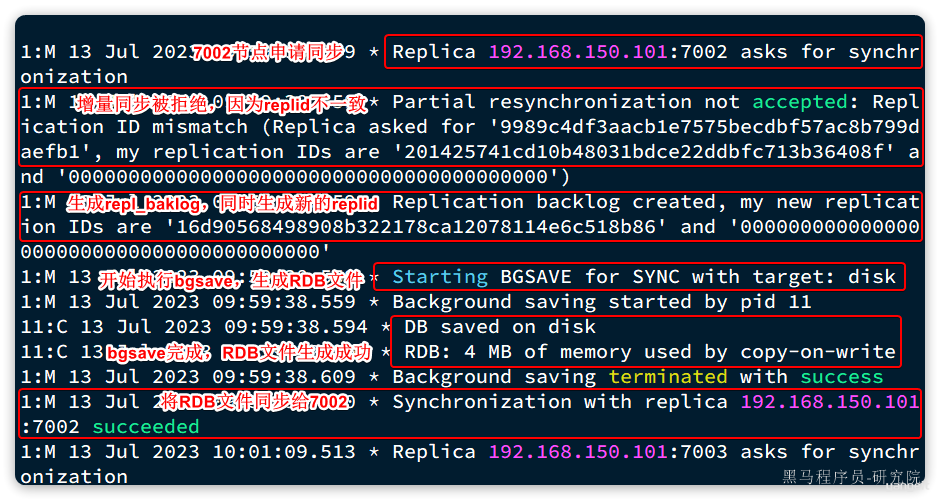
来看下 r1 节点的运行日志:
再看下 r2 节点执行 replicaof 命令时的日志:
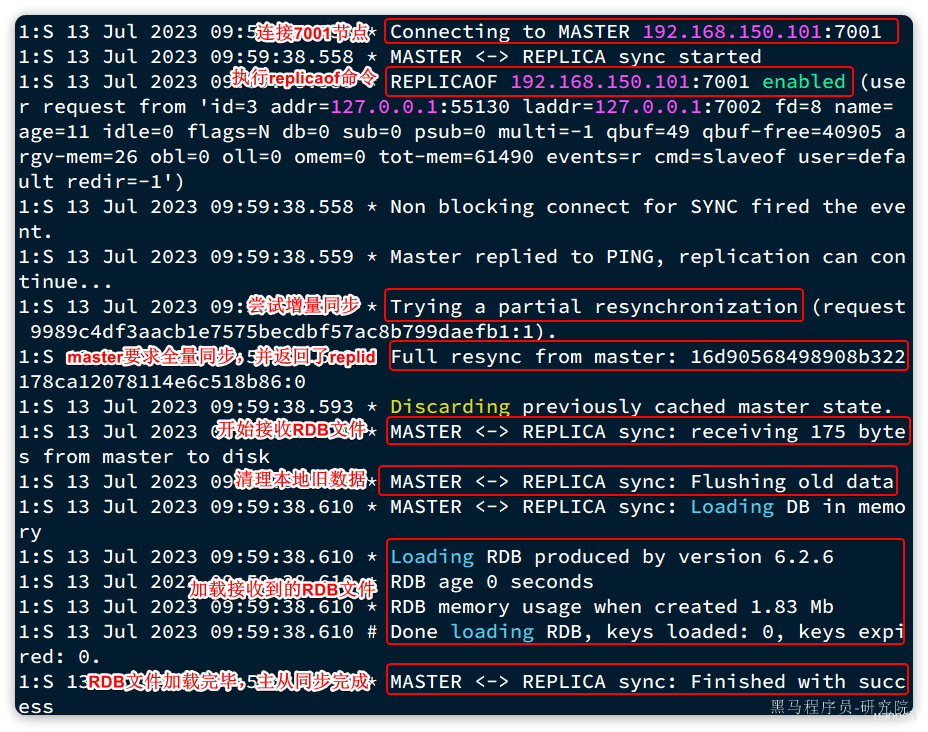
与我们描述的完全一致。
1.3.2.增量同步
全量同步需要先做 RDB,然后将 RDB 文件通过网络传输个 slave,成本太高了。因此除了第一次做全量同步,其它大多数时候 slave 与 master 都是做增量同步。
什么是增量同步?就是只更新 slave 与 master 存在差异的部分数据。如图:
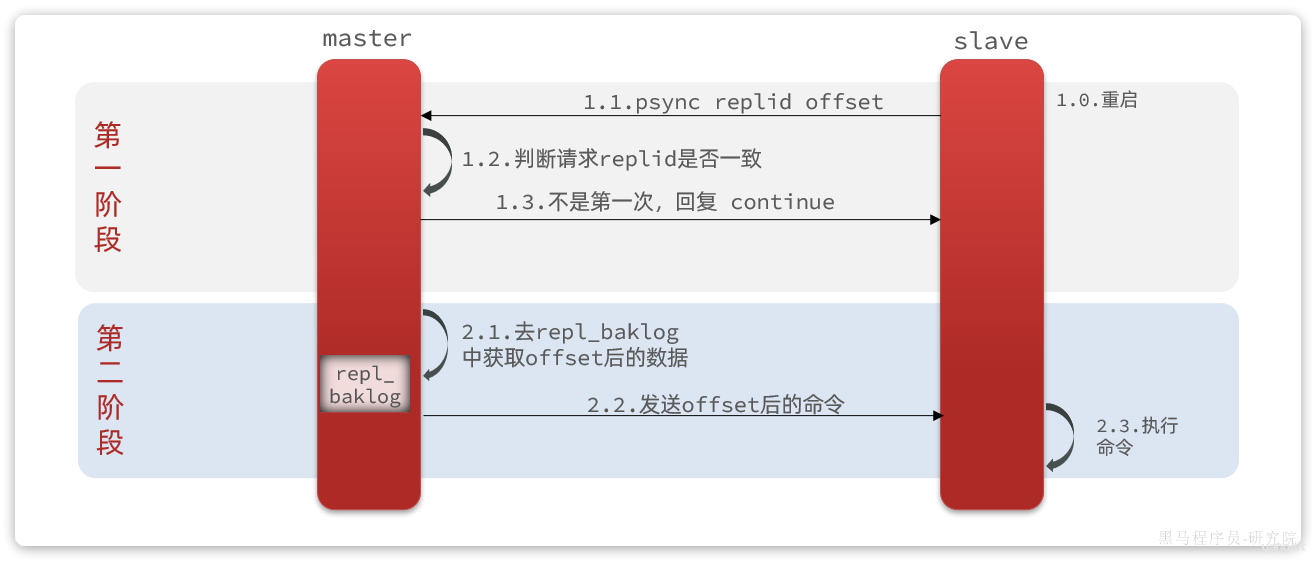
那么 master 怎么知道 slave 与自己的数据差异在哪里呢?
1.3.3.repl_baklog 原理
master 怎么知道 slave 与自己的数据差异在哪里呢?
这就要说到全量同步时的 repl_baklog 文件了。这个文件是一个固定大小的数组,只不过数组是环形,也就是说角标到达数组末尾后,会再次从 0 开始读写,这样数组头部的数据就会被覆盖。
repl_baklog 中会记录 Redis 处理过的命令及 offset,包括 master 当前的 offset,和 slave 已经拷贝到的 offset:
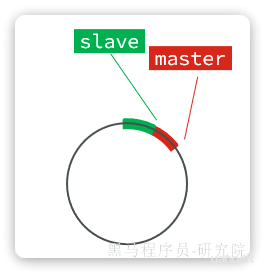
slave 与 master 的 offset 之间的差异,就是 salve 需要增量拷贝的数据了。
随着不断有数据写入,master 的 offset 逐渐变大,slave 也不断的拷贝,追赶 master 的 offset:
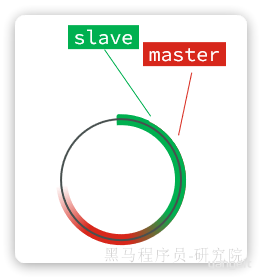
直到数组被填满:

此时,如果有新的数据写入,就会覆盖数组中的旧数据。不过,旧的数据只要是绿色的,说明是已经被同步到 slave 的数据,即便被覆盖了也没什么影响。因为未同步的仅仅是红色部分:
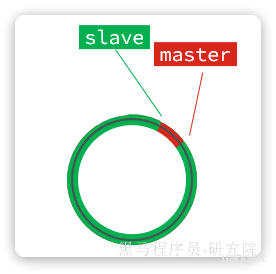
但是,如果 slave 出现网络阻塞,导致 master 的 offset 远远超过了 slave 的 offset:
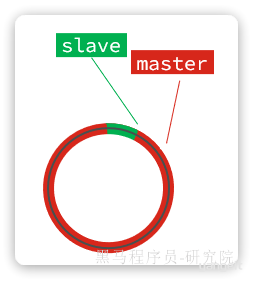
如果 master 继续写入新数据,master 的 offset 就会覆盖 repl_baklog 中旧的数据,直到将 slave 现在的 offset 也覆盖:
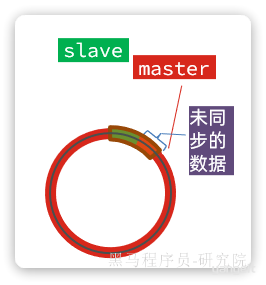
棕色框中的红色部分,就是尚未同步,但是却已经被覆盖的数据。此时如果 slave 恢复,需要同步,却发现自己的 offset 都没有了,无法完成增量同步了。只能做全量同步。
repl_baklog 大小有上限,写满后会覆盖最早的数据。如果 slave 断开时间过久,导致尚未备份的数据被覆盖,则无法基于 repl_baklog 做增量同步,只能再次全量同步。
1.4.主从同步优化
主从同步可以保证主从数据的一致性,非常重要。
可以从以下几个方面来优化 Redis 主从就集群:
- 在 master 中配置
repl-diskless-sync yes启用无磁盘复制,避免全量同步时的磁盘 IO。 - Redis 单节点上的内存占用不要太大,减少 RDB 导致的过多磁盘 IO
- 适当提高
repl_baklog的大小,发现 slave 宕机时尽快实现故障恢复,尽可能避免全量同步 - 限制一个 master 上的 slave 节点数量,如果实在是太多 slave,则可以采用
主-从-从链式结构,减少 master 压力
主-从-从 架构图:

简述全量同步和增量同步区别?
- 全量同步:master 将完整内存数据生成 RDB,发送 RDB 到 slave。后续命令则记录在 repl_baklog,逐个发送给 slave。
- 增量同步:slave 提交自己的 offset 到 master,master 获取 repl_baklog 中从 offset 之后的命令给 slave
什么时候执行全量同步?
- slave 节点第一次连接 master 节点时
- slave 节点断开时间太久,repl_baklog 中的 offset 已经被覆盖时
什么时候执行增量同步?
- slave 节点断开又恢复,并且在
repl_baklog中能找到 offset 时
2.Redis 哨兵
主从结构中 master 节点的作用非常重要,一旦故障就会导致集群不可用。那么有什么办法能保证主从集群的高可用性呢?
2.1.哨兵工作原理
Redis 提供了 哨兵(Sentinel)机制来监控主从集群监控状态,确保集群的高可用性。
2.1.1.哨兵作用
哨兵集群作用原理图:
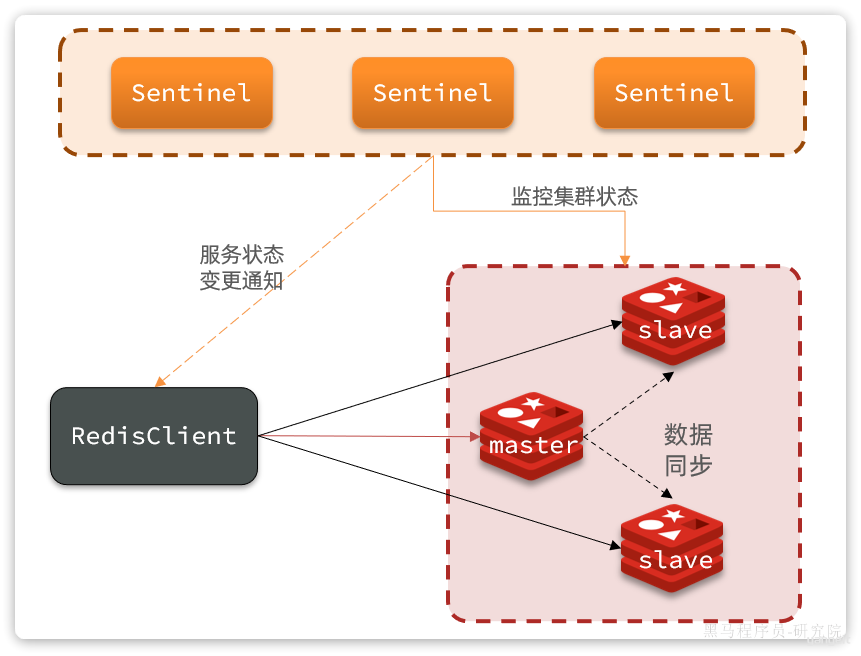
哨兵的作用如下:
- 状态监控:
Sentinel会不断检查您的master和slave是否按预期工作 - 故障恢复(failover):如果
master故障,Sentinel会将一个slave提升为master。当故障实例恢复后会成为slave - 状态通知:
Sentinel充当Redis客户端的服务发现来源,当集群发生failover时,会将最新集群信息推送给Redis的客户端
那么问题来了,Sentinel 怎么知道一个 Redis 节点是否宕机呢?
2.1.2.状态监控
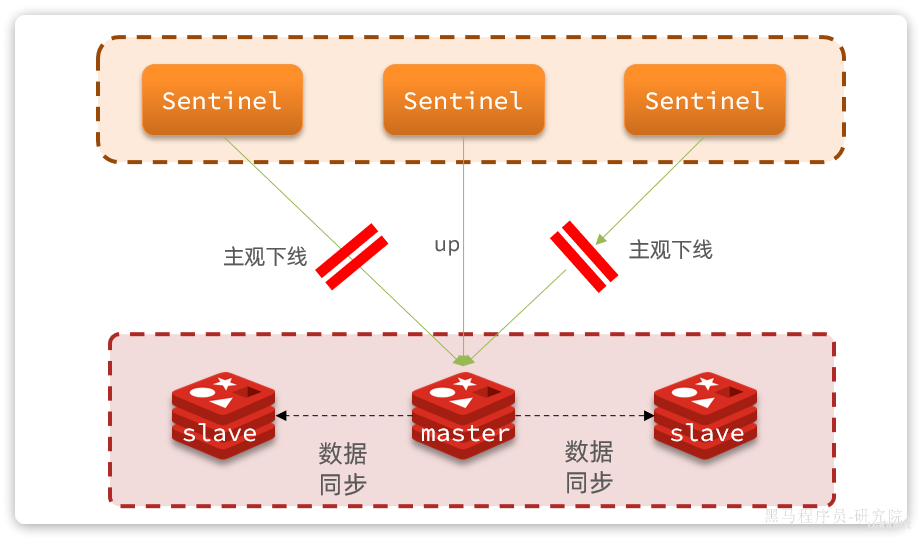
Sentinel 基于心跳机制监测服务状态,每隔 1 秒向集群的每个节点发送 ping 命令,并通过实例的响应结果来做出判断:
- 主观下线(sdown):如果某 sentinel 节点发现某 Redis 节点未在规定时间响应,则认为该节点主观下线。
- 客观下线(odown):若超过指定数量(通过
quorum设置)的 sentinel 都认为该节点主观下线,则该节点客观下线。quorum 值最好超过 Sentinel 节点数量的一半,Sentinel 节点数量至少 3 台。
如图:
一旦发现 master 故障,sentinel 需要在 salve 中选择一个作为新的 master,选择依据是这样的:
- 首先会判断 slave 节点与 master 节点断开时间长短,如果超过
down-after-milliseconds * 10则会排除该 slave 节点 - 然后判断 slave 节点的
slave-priority值,越小优先级越高,如果是 0 则永不参与选举(默认都是 1)。 - 如果
slave-prority一样,则判断 slave 节点的offset值,越大说明数据越新,优先级越高 - 最后是判断 slave 节点的
run_id大小,越小优先级越高(通过info server可以查看run_id)。
对应的官方文档如下:
问题来了,当选出一个新的 master 后,该如何实现身份切换呢?
大概分为两步:
- 在多个
sentinel中选举一个leader - 由
leader执行failover
2.1.3.选举 leader
首先,Sentinel 集群要选出一个执行 failover 的 Sentinel 节点,可以成为 leader。要成为 leader 要满足两个条件:
- 最先获得超过半数的投票
- 获得的投票数不小于
quorum值
而 sentinel 投票的原则有两条:
- 优先投票给目前得票最多的
- 如果目前没有任何节点的票,就投给自己
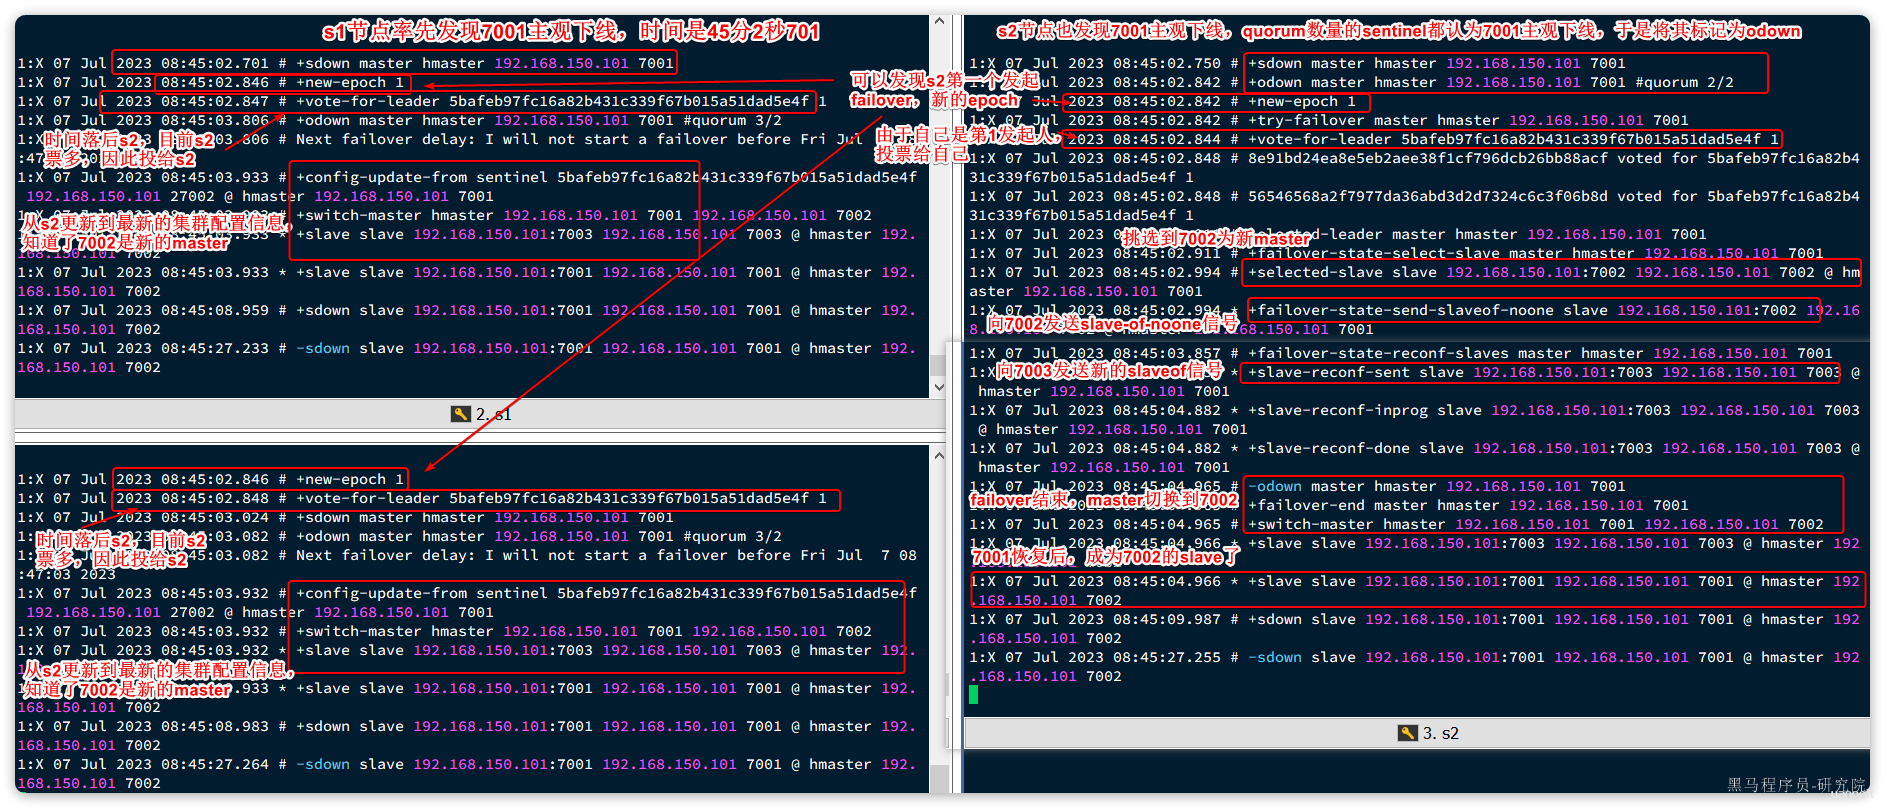
比如有 3 个 sentinel 节点,s1、s2、s3,假如 s2 先投票:
- 此时发现没有任何人在投票,那就投给自己。
s2得 1 票 - 接着
s1和s3开始投票,发现目前s2票最多,于是也投给s2,s2得 3 票 s2称为leader,开始故障转移
不难看出,谁先投票,谁就会称为****leader,那什么时候会触发投票呢?
答案是第一个确认master客观下线的人会立刻发起投票,一定会成为****leader。
OK,sentinel 找到 leader 以后,该如何完成 failover 呢?
2.1.4.failover
我们举个例子,有一个集群,初始状态下 7001 为 master,7002 和 7003 为 slave:

假如 master 发生故障,slave1 当选。则故障转移的流程如下:
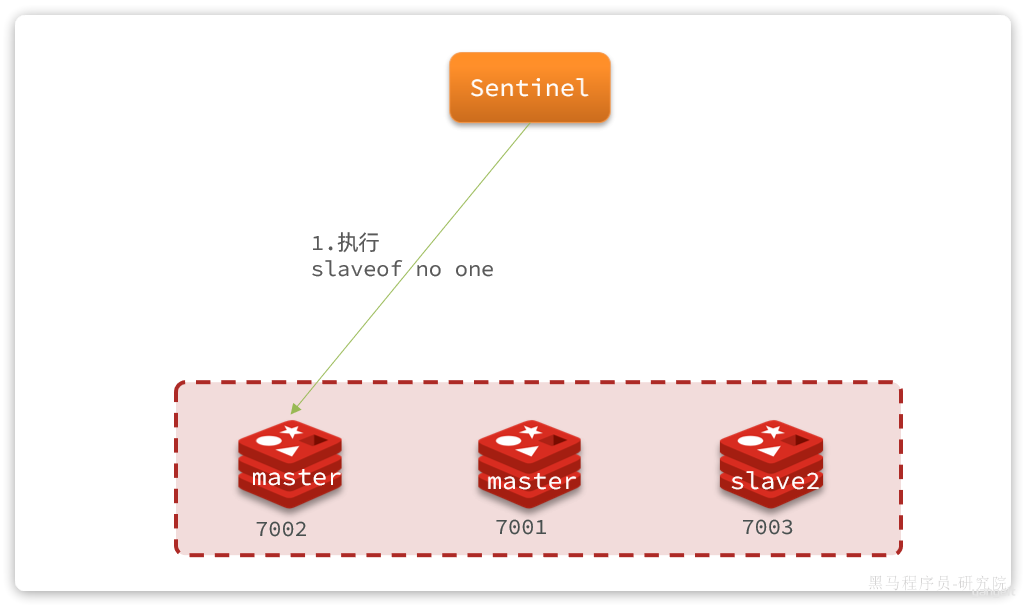
1)sentinel 给备选的 slave1 节点发送 slaveof no one 命令,让该节点成为 master
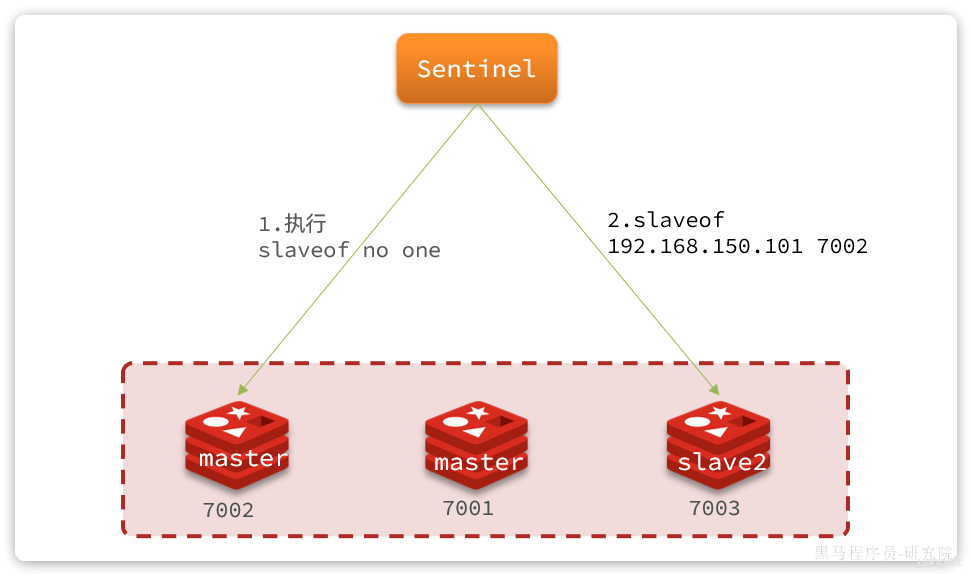
2)sentinel 给所有其它 slave 发送 slaveof 192.168.150.101 7002 命令,让这些节点成为新 master,也就是 7002 的 slave 节点,开始从新的 master 上同步数据。
3)最后,当故障节点恢复后会接收到哨兵信号,执行 slaveof 192.168.150.101 7002 命令,成为 slave:

2.2.搭建哨兵集群
首先,我们停掉之前的 redis 集群:
docker-compose down
然后,我们找到课前资料提供的 sentinel.conf 文件:
其内容如下:
sentinel announce-ip "192.168.150.101"
sentinel monitor hmaster 192.168.150.101 7003 2
sentinel down-after-milliseconds hmaster 5000
sentinel failover-timeout hmaster 60000
说明:
sentinel announce-ip "192.168.150.101":声明当前 sentinel 的 ipsentinel monitor hmaster 192.168.150.101 7001 2:指定集群的主节点信息hmaster:主节点名称,自定义,任意写192.168.150.101 7001:主节点的 ip 和端口2:认定master下线时的quorum值
sentinel down-after-milliseconds hmaster 5000:声明 master 节点超时多久后被标记下线sentinel failover-timeout hmaster 60000:在第一次故障转移失败后多久再次重试
我们在虚拟机的 /root/redis 目录下新建 3 个文件夹:s1、s2、s3:

将课前资料提供的 sentinel.conf 文件分别拷贝一份到 3 个文件夹中。
接着修改 docker-compose.yaml 文件,内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002", "--slaveof", "192.168.150.101", "7001"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003", "--slaveof", "192.168.150.101", "7001"]
  s1:
    image: redis
    container_name: s1
    volumes:
      - /root/redis/s1:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27001"]
  s2:
    image: redis
    container_name: s2
    volumes:
      - /root/redis/s2:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27002"]
  s3:
    image: redis
    container_name: s3
    volumes:
      - /root/redis/s3:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27003"]
直接运行命令,启动集群:
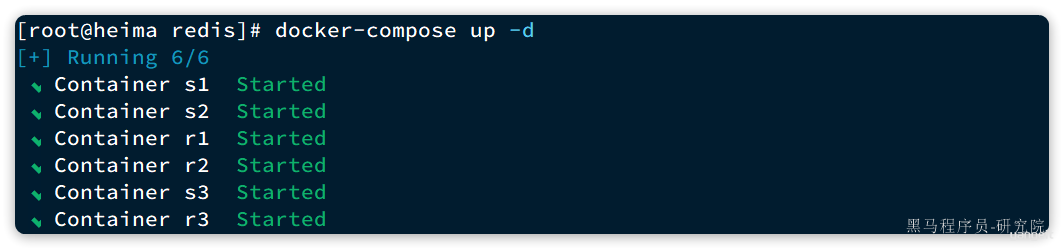
docker-compose up -d
运行结果:
我们以 s1 节点为例,查看其运行日志:
# Sentinel ID is 8e91bd24ea8e5eb2aee38f1cf796dcb26bb88acf
# +monitor master hmaster 192.168.150.101 7001 quorum 2
* +slave slave 192.168.150.101:7003 192.168.150.101 7003 @ hmaster 192.168.150.101 7001
* +sentinel sentinel 5bafeb97fc16a82b431c339f67b015a51dad5e4f 192.168.150.101 27002 @ hmaster 192.168.150.101 7001
* +sentinel sentinel 56546568a2f7977da36abd3d2d7324c6c3f06b8d 192.168.150.101 27003 @ hmaster 192.168.150.101 7001
* +slave slave 192.168.150.101:7002 192.168.150.101 7002 @ hmaster 192.168.150.101 7001
可以看到 sentinel 已经联系到了 7001 这个节点,并且与其它几个哨兵也建立了链接。哨兵信息如下:
27001:Sentinel ID是8e91bd24ea8e5eb2aee38f1cf796dcb26bb88acf27002:Sentinel ID是5bafeb97fc16a82b431c339f67b015a51dad5e4f27003:Sentinel ID是56546568a2f7977da36abd3d2d7324c6c3f06b8d
2.3.演示 failover
接下来,我们演示一下当主节点故障时,哨兵是如何完成集群故障恢复(failover)的。
我们连接 7001 这个 master 节点,然后通过命令让其休眠 60 秒,模拟宕机:
# 连接7001这个master节点,通过sleep模拟服务宕机,60秒后自动恢复
docker exec -it r1 redis-cli -p 7001 DEBUG sleep 60
稍微等待一段时间后,会发现 sentinel 节点触发了 failover:
2.4.总结
Sentinel 的三个作用是什么?
- 集群监控
- 故障恢复
- 状态通知
Sentinel 如何判断一个 redis 实例是否健康?
- 每隔 1 秒发送一次 ping 命令,如果超过一定时间没有相向则认为是主观下线(
sdown) - 如果大多数 sentinel 都认为实例主观下线,则判定服务客观下线(
odown)
故障转移步骤有哪些?
- 首先要在
sentinel中选出一个leader,由 leader 执行failover - 选定一个
slave作为新的master,执行slaveof noone,切换到 master 模式 - 然后让所有节点都执行
slaveof新 master - 修改故障节点配置,添加
slaveof新 master
sentinel 选举 leader 的依据是什么?
- 票数超过 sentinel 节点数量 1 半
- 票数超过 quorum 数量
- 一般情况下最先发起 failover 的节点会当选
sentinel 从 slave 中选取 master 的依据是什么?
- 首先会判断 slave 节点与 master 节点断开时间长短,如果超过
down-after-milliseconds * 10则会排除该 slave 节点 - 然后判断 slave 节点的
slave-priority值,越小优先级越高,如果是 0 则永不参与选举(默认都是 1)。 - 如果
slave-prority一样,则判断 slave 节点的offset值,越大说明数据越新,优先级越高 - 最后是判断 slave 节点的
run_id大小,越小优先级越高(通过info server可以查看run_id)。
2.5.RedisTemplate 连接哨兵集群(选学)
分为三步:
- 1)引入依赖
- 2)配置哨兵地址
- 3)配置读写分离
2.5.1.引入依赖
就是 SpringDataRedis 的依赖:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
2.5.2.配置哨兵地址
连接哨兵集群与传统单点模式不同,不再需要设置每一个 redis 的地址,而是直接指定哨兵地址:
spring:
  redis:
    sentinel:
      master: hmaster # 集群名
      nodes: # 哨兵地址列表
        - 192.168.150.101:27001
        - 192.168.150.101:27002
        - 192.168.150.101:27003
2.5.3.配置读写分离
最后,还要配置读写分离,让 java 客户端将写请求发送到 master 节点,读请求发送到 slave 节点。定义一个 bean 即可:
@Bean
public LettuceClientConfigurationBuilderCustomizer clientConfigurationBuilderCustomizer(){
    return clientConfigurationBuilder -> clientConfigurationBuilder.readFrom(ReadFrom.REPLICA_PREFERRED);
}
这个 bean 中配置的就是读写策略,包括四种:
MASTER:从主节点读取MASTER_PREFERRED:优先从master节点读取,master不可用才读取slaveREPLICA:从slave节点读取REPLICA_PREFERRED:优先从slave节点读取,所有的slave都不可用才读取master
3.Redis 分片集群
主从模式可以解决高可用、高并发读的问题。但依然有两个问题没有解决:
- 海量数据存储
- 高并发写
要解决这两个问题就需要用到分片集群了。分片的意思,就是把数据拆分存储到不同节点,这样整个集群的存储数据量就更大了。
Redis 分片集群的结构如图:

分片集群特征:
- 集群中有多个 master,每个 master 保存不同分片数据 ,解决海量数据存储问题
- 每个 master 都可以有多个 slave 节点 ,确保高可用
- master 之间通过 ping 监测彼此健康状态 ,类似哨兵作用
- 客户端请求可以访问集群任意节点,最终都会被转发到数据所在节点
3.1.搭建分片集群
Redis 分片集群最少也需要 3 个 master 节点,由于我们的机器性能有限,我们只给每个 master 配置 1 个 slave,形成最小的分片集群:

计划部署的节点信息如下:
3.1.1.集群配置
分片集群中的 Redis 节点必须开启集群模式,一般在配置文件中添加下面参数:
port 7000
cluster-enabled yes
cluster-config-file nodes.conf
cluster-node-timeout 5000
appendonly yes
其中有 3 个我们没见过的参数:
cluster-enabled:是否开启集群模式cluster-config-file:集群模式的配置文件名称,无需手动创建,由集群自动维护cluster-node-timeout:集群中节点之间心跳超时时间
一般搭建部署集群肯定是给每个节点都配置上述参数,不过考虑到我们计划用 docker-compose 部署,因此可以直接在启动命令中指定参数,偷个懒。
在虚拟机的 /root 目录下新建一个 redis-cluster 目录,然后在其中新建一个 docker-compose.yaml 文件,内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r4:
    image: redis
    container_name: r4
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7004", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r5:
    image: redis
    container_name: r5
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7005", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r6:
    image: redis
    container_name: r6
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7006", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
注意:使用 Docker 部署 Redis 集群,network 模式必须采用 host
3.1.2.启动集群
进入 /root/redis-cluster 目录,使用命令启动 redis:
docker-compose up -d
启动成功,可以通过命令查看启动进程:
ps -ef | grep redis
# 结果:
root       4822   4743  0 14:29 ?        00:00:02 redis-server *:7002 [cluster]
root       4827   4745  0 14:29 ?        00:00:01 redis-server *:7005 [cluster]
root       4897   4778  0 14:29 ?        00:00:01 redis-server *:7004 [cluster]
root       4903   4759  0 14:29 ?        00:00:01 redis-server *:7006 [cluster]
root       4905   4775  0 14:29 ?        00:00:02 redis-server *:7001 [cluster]
root       4912   4732  0 14:29 ?        00:00:01 redis-server *:7003 [cluster]
可以发现每个 redis 节点都以 cluster 模式运行。不过节点与节点之间并未建立连接。
接下来,我们使用命令创建集群:
# 进入任意节点容器
docker exec -it r1 bash
# 然后,执行命令
redis-cli --cluster create --cluster-replicas 1 \
192.168.150.101:7001 192.168.150.101:7002 192.168.150.101:7003 \
192.168.150.101:7004 192.168.150.101:7005 192.168.150.101:7006
命令说明:
redis-cli --cluster:代表集群操作命令create:代表是创建集群--cluster-replicas 1:指定集群中每个master的副本个数为 1- 此时
节点总数 ÷ (replicas + 1)得到的就是master的数量n。因此节点列表中的前n个节点就是master,其它节点都是slave节点,随机分配到不同master
- 此时
输入命令后控制台会弹出下面的信息:
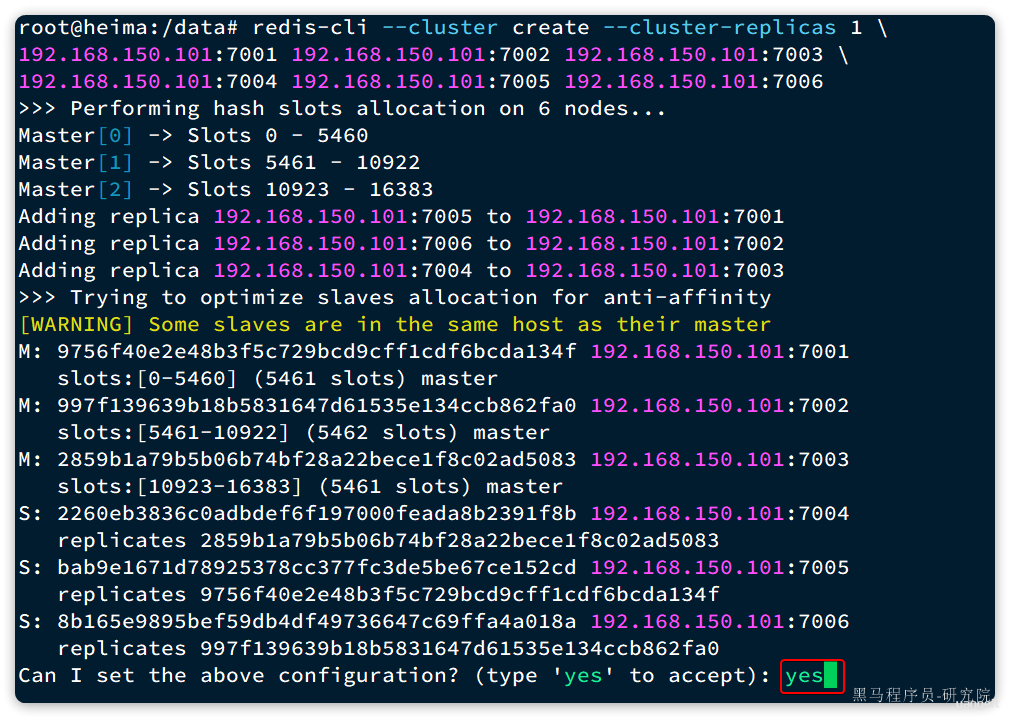
这里展示了集群中 master 与 slave 节点分配情况,并询问你是否同意。节点信息如下:
7001是master,节点id后 6 位是da134f7002是master,节点id后 6 位是862fa07003是master,节点id后 6 位是ad50837004是slave,节点id后 6 位是391f8b,认ad5083(7003)为master7005是slave,节点id后 6 位是e152cd,认da134f(7001)为master7006是slave,节点id后 6 位是4a018a,认862fa0(7002)为master
输入 yes 然后回车。会发现集群开始创建,并输出下列信息:
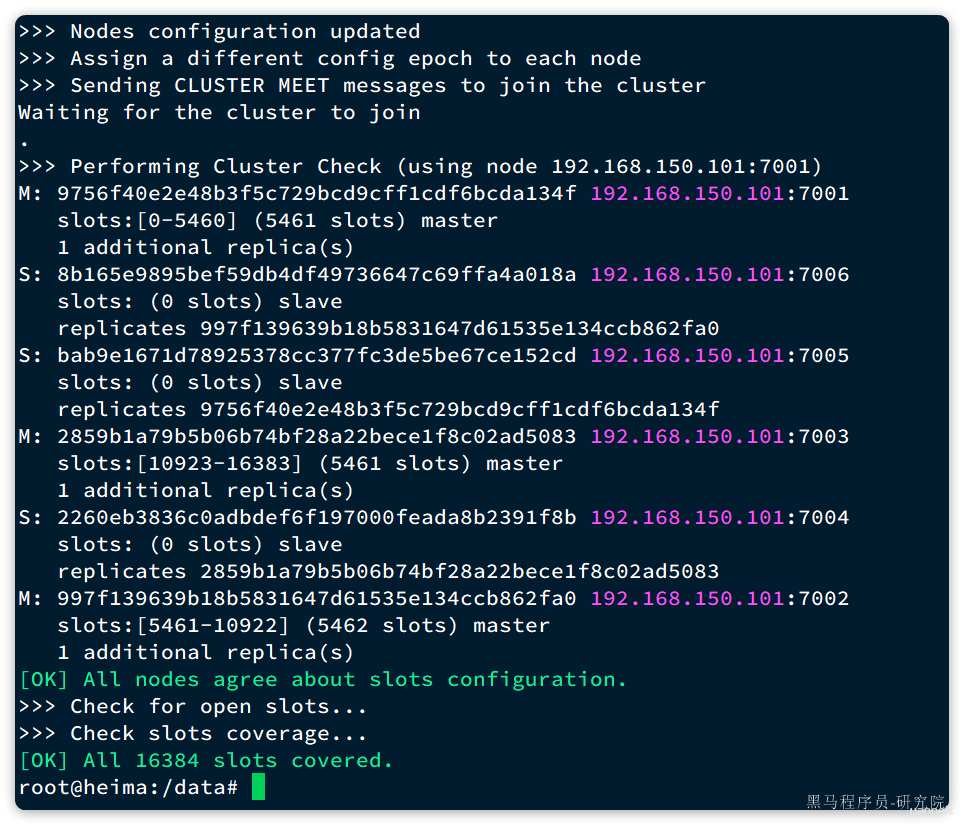
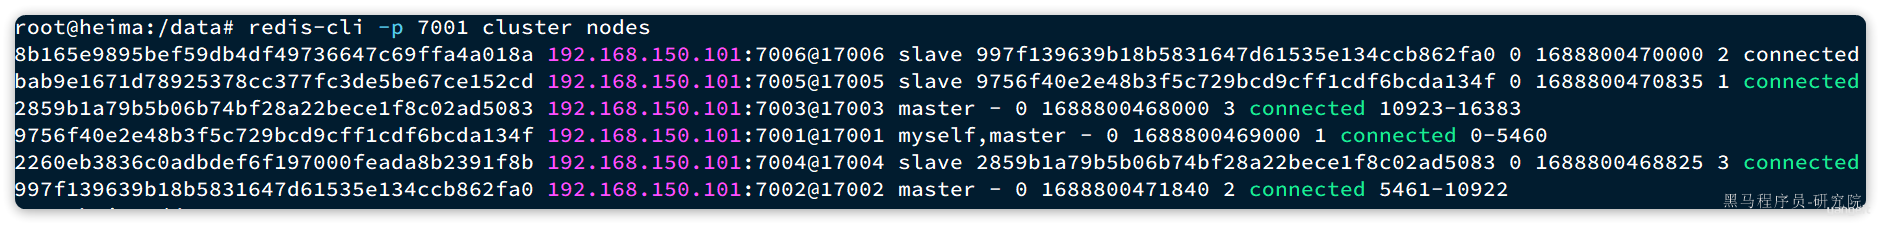
接着,我们可以通过命令查看集群状态:
redis-cli -p 7001 cluster nodes
结果:
3.2.散列插槽
数据要分片存储到不同的 Redis 节点,肯定需要有分片的依据,这样下次查询的时候才能知道去哪个节点查询。很多数据分片都会采用一致性 hash 算法。而 Redis 则是利用散列插槽(hash slot)的方式实现数据分片。
详见官方文档:
在 Redis 集群中,共有 16384 个 hash slots,集群中的每一个 master 节点都会分配一定数量的 hash slots。具体的分配在集群创建时就已经指定了:
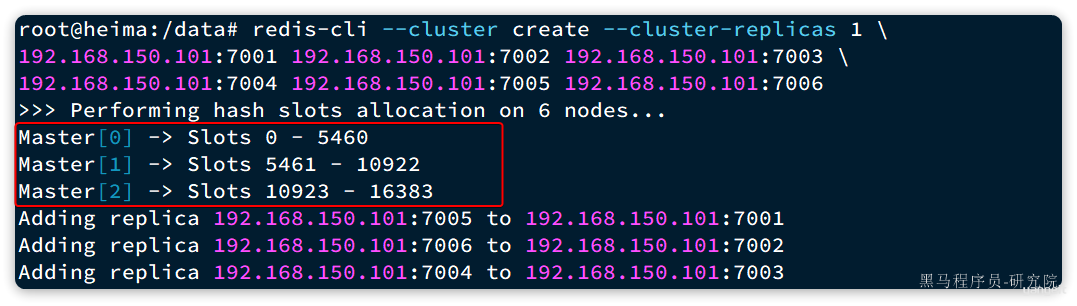
如图中所示:
- Master[0],本例中就是 7001 节点,分配到的插槽是 0~5460
- Master[1],本例中就是 7002 节点,分配到的插槽是 5461~10922
- Master[2],本例中就是 7003 节点,分配到的插槽是 10923~16383
当我们读写数据时,Redis 基于 CRC16 算法对 key 做 hash 运算,得到的结果与 16384 取余,就计算出了这个 key 的 slot 值。然后到 slot 所在的 Redis 节点执行读写操作。
不过 hash slot 的计算也分两种情况:
- 当
key中包含{}时,根据{}之间的字符串计算hash slot - 当
key中不包含{}时,则根据整个key字符串计算hash slot
例如:
- key 是
user,则根据user来计算 hash slot - key 是
user:{age},则根据age来计算 hash slot
我们来测试一下,先于 7001 建立连接:
# 进入容器
docker exec -it r1 bash
# 进入redis-cli
redis-cli -p 7001
# 测试
set user jack
会发现报错了:
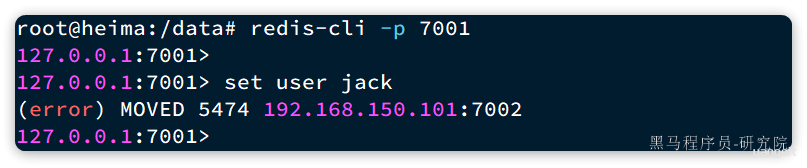
提示我们 MOVED 5474,其实就是经过计算,得出 user 这个 key 的 hash slot 是 5474,而 5474 是在 7002 节点,不能在 7001 上写入!!
说好的任意节点都可以读写呢?
这是因为我们连接的方式有问题,连接集群时,要加 -c 参数:
# 通过7001连接集群
redis-cli -c -p 7001
# 存入数据
set user jack
结果如下:

可以看到,客户端自动跳转到了 5474 这个 slot 所在的 7002 节点。
现在,我们添加一个新的 key,这次加上 {}:
# 试一下key中带{}
set user:{age} 21

# 再试一下key中不带{}
set age 20
结果如下:
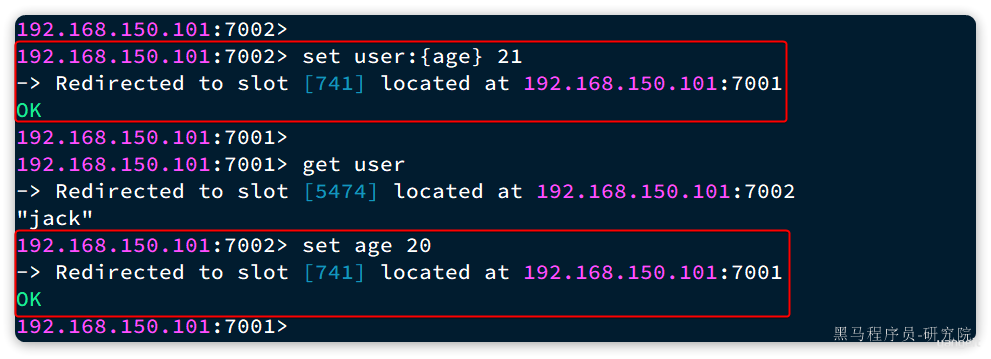
可以看到 user:{age} 和 age 计算出的 slot 都是 741。
3.3.故障转移
分片集群的节点之间会互相通过 ping 的方式做心跳检测,超时未回应的节点会被标记为下线状态。当发现 master 下线时,会将这个 master 的某个 slave 提升为 master。
我们先打开一个控制台窗口,利用命令监测集群状态:
watch docker exec -it r1 redis-cli -p 7001 cluster nodes
命令前面的 watch 可以每隔一段时间刷新执行结果,方便我们实时监控集群状态变化。
接着,我们故技重施,利用命令让某个 master 节点休眠。比如这里我们让 7002 节点休眠,打开一个新的 ssh 控制台,输入下面命令:
docker exec -it r2 redis-cli -p 7002 DEBUG sleep 30
可以观察到,集群发现 7002 宕机,标记为下线:
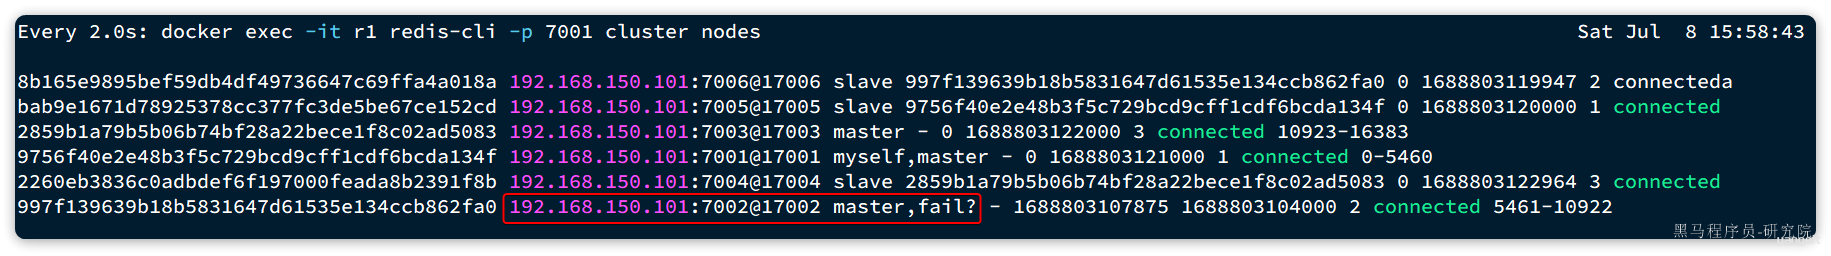
过了一段时间后,7002 原本的小弟 7006 变成了 master:

而 7002 被标记为 slave,而且其 master 正好是 7006,主从地位互换。
3.4.总结
Redis 分片集群如何判断某个 key 应该在哪个实例?
- 将 16384 个插槽分配到不同的实例
- 根据 key 计算哈希值,对 16384 取余
- 余数作为插槽,寻找插槽所在实例即可
如何将同一类数据固定的保存在同一个 Redis 实例?
- Redis 计算 key 的插槽值时会判断 key 中是否包含
{},如果有则基于{}内的字符计算插槽 - 数据的 key 中可以加入
{类型},例如 key 都以{typeId}为前缀,这样同类型数据计算的插槽一定相同
3.5.Java 客户端连接分片集群(选学)
RedisTemplate 底层同样基于 lettuce 实现了分片集群的支持,而使用的步骤与哨兵模式基本一致,参考 2.5节:
1)引入 redis 的 starter 依赖
2)配置分片集群地址
3)配置读写分离
与哨兵模式相比,其中只有分片集群的配置方式略有差异,如下:
spring:
  redis:
    cluster:
      nodes:
        - 192.168.150.101:7001
        - 192.168.150.101:7002
        - 192.168.150.101:7003
        - 192.168.150.101:8001
        - 192.168.150.101:8002
        - 192.168.150.101:8003
4.Redis 数据结构
我们常用的 Redis 数据类型有 5 种,分别是:
- String
- List
- Set
- SortedSet
- Hash
还有一些高级数据类型,比如 Bitmap、HyperLogLog、GEO 等,其底层都是基于上述 5 种基本数据类型。因此在 Redis 的源码中,其实只有 5 种数据类型。
4.1.RedisObject
不管是任何一种数据类型,最终都会封装为 RedisObject 格式,它是一种结构体,C 语言中的一种结构,可以理解为 Java 中的类。
结构大概是这样的:
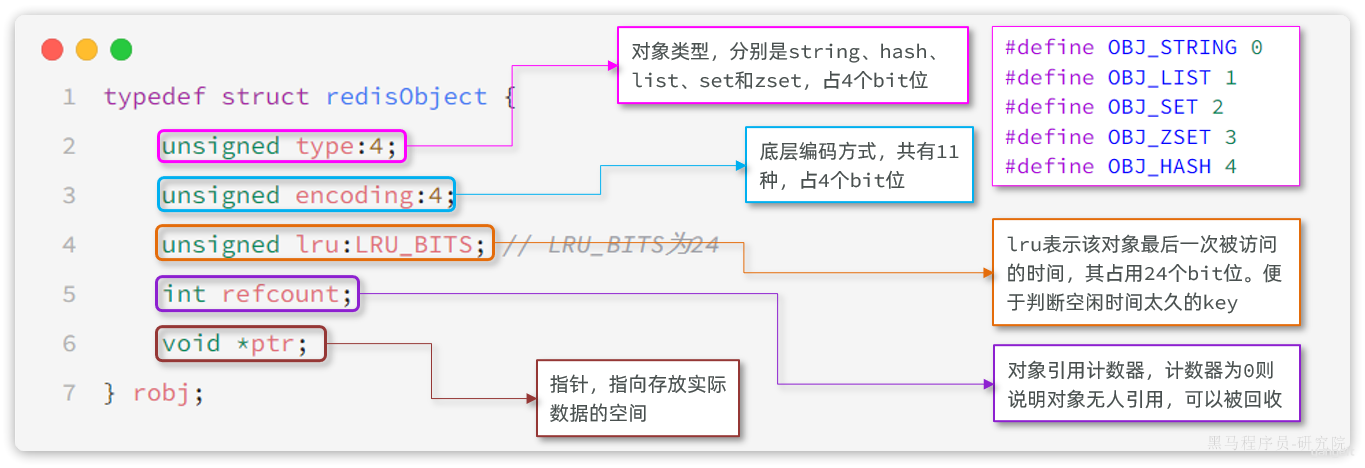
可以看到整个结构体中并不包含真实的数据,仅仅是对象头信息,内存占用的大小为 4+4+24+32+64 = 128bit
也就是 16 字节,然后指针 ptr 指针指向的才是真实数据存储的内存地址。所以 RedisObject 的内存开销是很大的。
属性中的 encoding 就是当前对象底层采用的数据结构或编码方式,可选的有 11 种之多:
| ##### 编号 | ##### 编码方式 | ##### 说明 |
|---|---|---|
| 0 | OBJ_ENCODING_RAW | raw 编码动态字符串 |
| 1 | OBJ_ENCODING_INT | long 类型的整数的字符串 |
| 2 | OBJ_ENCODING_HT | hash 表(也叫 dict) |
| 3 | OBJ_ENCODING_ZIPMAP | 已废弃 |
| 4 | OBJ_ENCODING_LINKEDLIST | 双端链表 |
| 5 | OBJ_ENCODING_ZIPLIST | 压缩列表 |
| 6 | OBJ_ENCODING_INTSET | 整数集合 |
| 7 | OBJ_ENCODING_SKIPLIST | 跳表 |
| 8 | OBJ_ENCODING_EMBSTR | embstr 编码的动态字符串 |
| 9 | OBJ_ENCODING_QUICKLIST | 快速列表 |
| 10 | OBJ_ENCODING_STREAM | Stream 流 |
| 11 | OBJ_ENCODING_LISTPACK | 紧凑列表 |
Redis 中的 5 种不同的数据类型采用的底层数据结构和编码方式如下:
| ##### 数据类型 | ##### 编码方式 |
|---|---|
| STRING | int、embstr、raw |
| LIST | LinkedList和ZipList(3.2 以前)、QuickList(3.2 以后) |
| SET | intset、HT |
| ZSET | ZipList(7.0 以前)、Listpack(7.0 以后)、HT、SkipList |
| HASH | ZipList(7.0 以前)、Listpack(7.0 以后)、HT |
这些数据类型比较复杂,我们重点讲解几个面试会问的,其它的大家可以查看黑马程序员发布的 Redis 专业课程:
4.2.SkipList
SkipList(跳表)首先是链表,但与传统链表相比有几点差异:
- 元素按照升序排列存储
- 节点可能包含多个指针,指针跨度不同。
传统链表只有指向前后元素的指针,因此只能顺序依次访问。如果查找的元素在链表中间,查询的效率会比较低。而 SkipList 则不同,它内部包含跨度不同的多级指针,可以让我们跳跃查找链表中间的元素,效率非常高。
其结构如图:
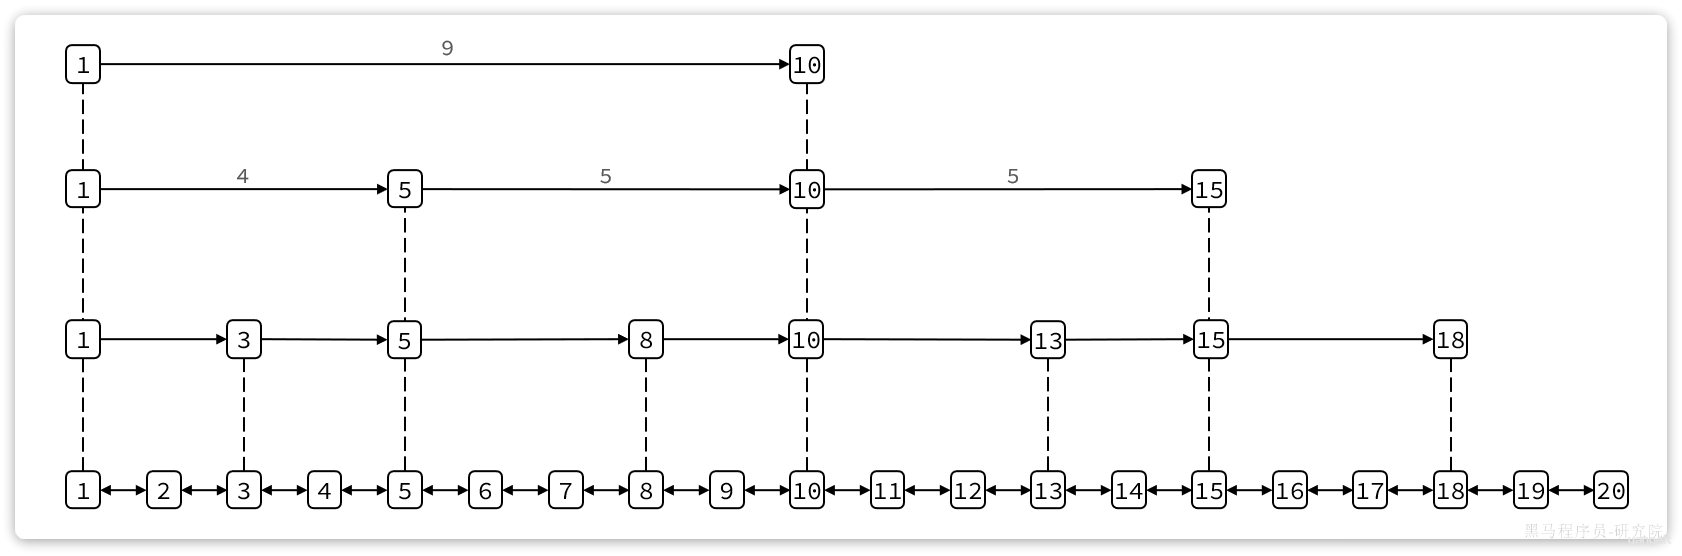
我们可以看到 1 号元素就有指向 3、5、10 的多个指针,查询时就可以跳跃查找。例如我们要找大小为 14 的元素,查找的流程是这样的:
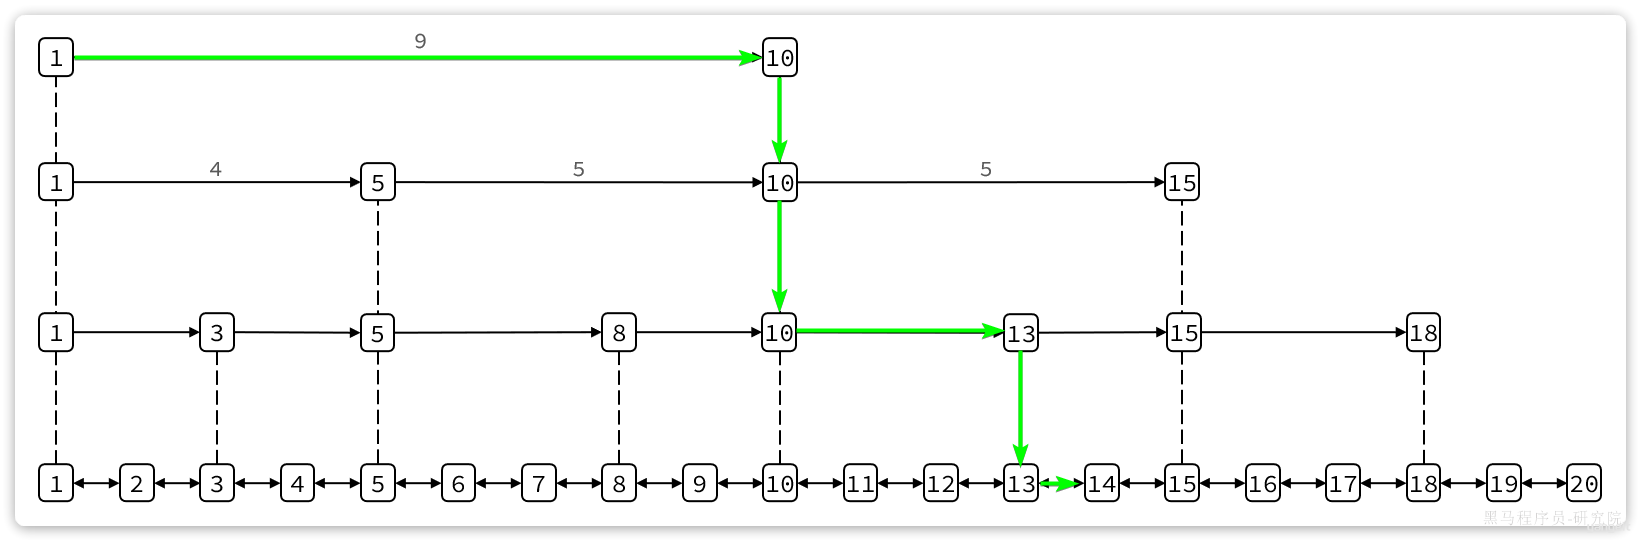
- 首先找元素 1 节点最高级指针,也就是 4 级指针,起始元素大小为 1,指针跨度为 9,可以判断出目标元素大小为 10。由于 14 比 10 大,肯定要从 10 这个元素向下接着找。
- 找到 10 这个元素,发现 10 这个元素的最高级指针跨度为 5,判断出目标元素大小为 15,大于 14,需要判断下级指针
- 10 这个元素的 2 级指针跨度为 3,判断出目标元素为 13,小于 14,因此要基于元素 13 接着找
- 13 这个元素最高级级指针跨度为 2,判断出目标元素为 15,比 14 大,需要判断下级指针。
- 13 的下级指针跨度为 1,因此目标元素是 14,刚好于目标一致,找到。
这种多级指针的查询方式就避免了传统链表的逐个遍历导致的查询效率下降问题。在对有序数据做随机查询和排序时效率非常高。
跳表的结构体如下:
typedef struct zskiplist {
    // 头尾节点指针
    struct zskiplistNode *header, *tail;
    // 节点数量
    unsigned long length;
    // 最大的索引层级
    int level;
} zskiplist;
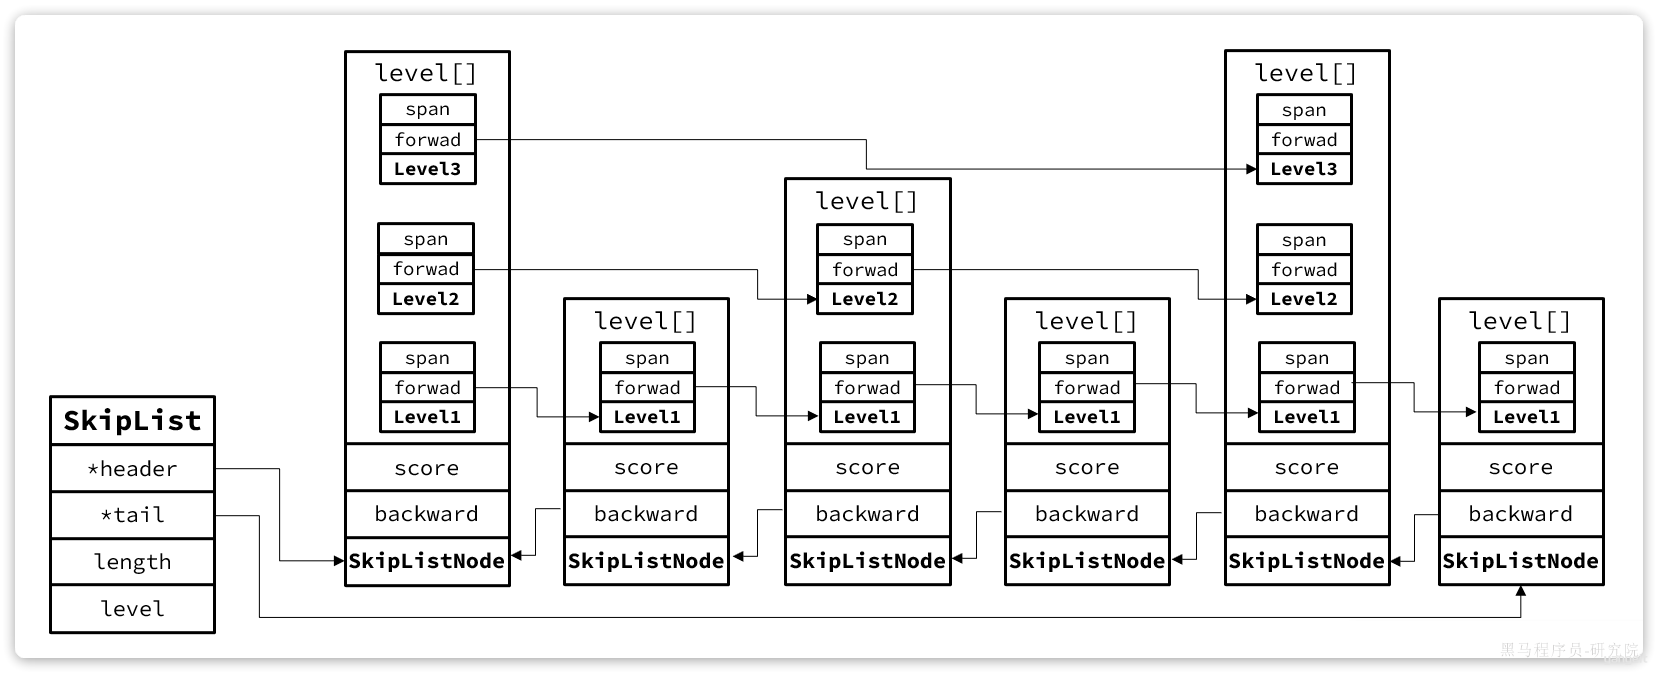
可以看到 SkipList 主要属性是 header 和 tail,也就是头尾指针,因此它是支持双向遍历的。
跳表中节点的结构体如下:
typedef struct zskiplistNode {
    sds ele; // 节点存储的字符串
    double score;// 节点分数,排序、查找用
    struct zskiplistNode *backward; // 前一个节点指针
    struct zskiplistLevel {
        struct zskiplistNode *forward; // 下一个节点指针
        unsigned long span; // 索引跨度
    } level[]; // 多级索引数组
} zskiplistNode;
每个节点中都包含 ele 和 score 两个属性,其中 score 是得分,也就是节点排序的依据。ele 则是节点存储的字符串数据指针。
其内存结构如下:
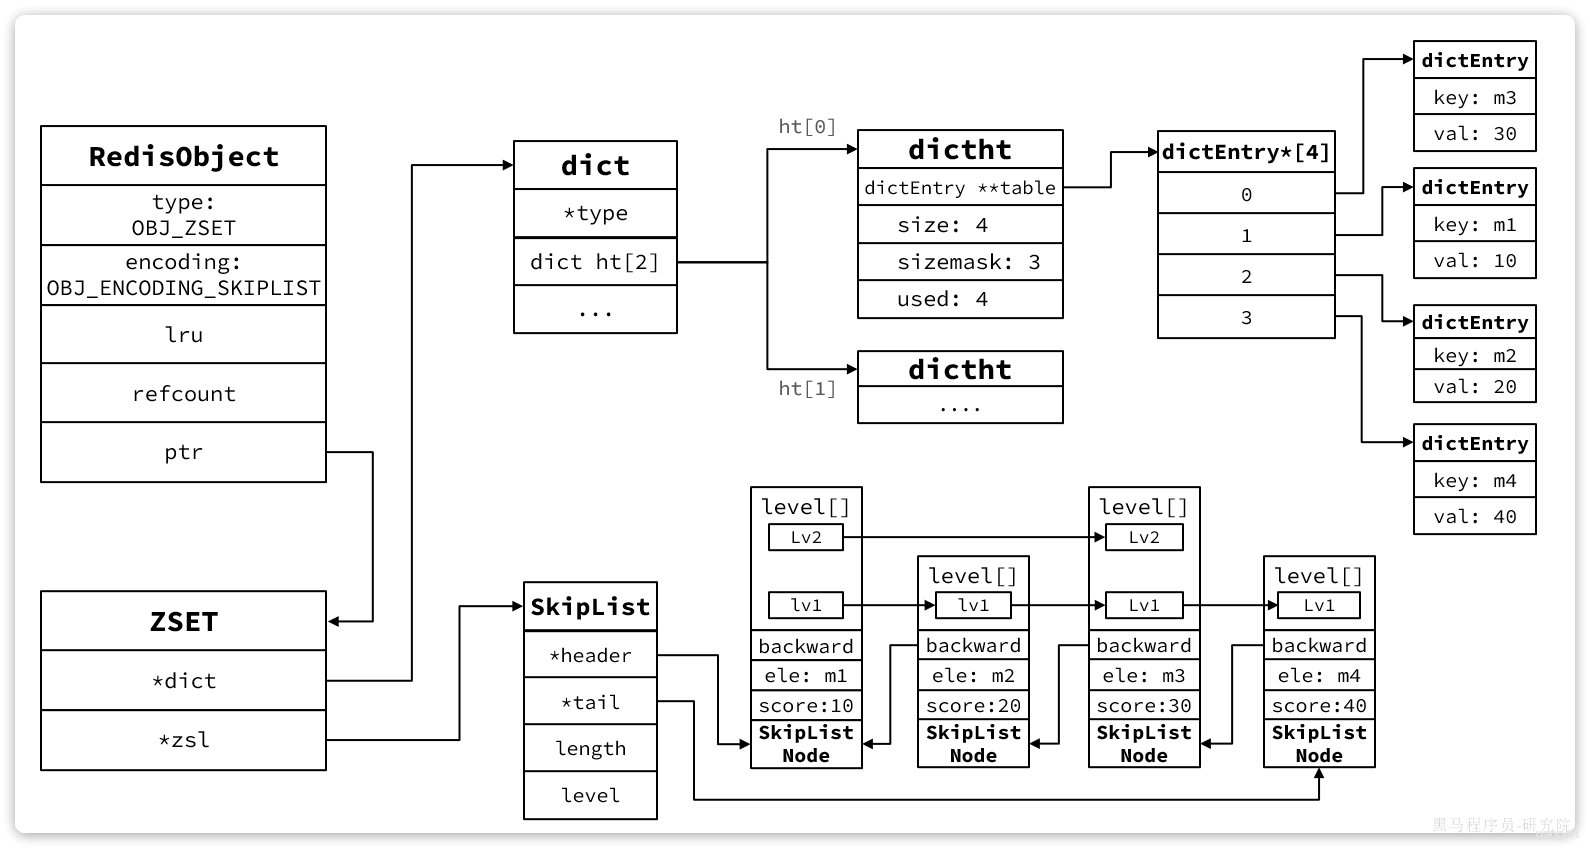
4.3.SortedSet
Redis 源码中 zset,也就是 SortedSet 的结构体如下:
typedef struct zset {
    dict *dict; // dict,底层就是HashTable
    zskiplist *zsl; // 跳表
} zset;
其内存结构如图:
5.Redis 内存回收
Redis 之所以性能强,最主要的原因就是基于内存存储。然而单节点的 Redis 其内存大小不宜过大,会影响持久化或主从同步性能。
我们可以通过修改 redis.conf 文件,添加下面的配置来配置 Redis 的最大内存:
maxmemory 1gb
当内存达到上限,就无法存储更多数据了。因此,Redis 内部会有两套内存回收的策略:
- 内存过期策略
- 内存淘汰策略
5.1.内存过期处理
存入 Redis 中的数据可以配置过期时间,到期后再次访问会发现这些数据都不存在了,也就是被过期清理了。
5.1.1.过期命令
Redis 中通过 expire 命令可以给 KEY 设置 TTL(过期时间),例如:
# 写入一条数据
set num 123
# 设置20秒过期时间
expire num 20
不过 set 命令本身也可以支持过期时间的设置:
# 写入一条数据并设置20s过期时间
set num EX 20
当过期时间到了以后,再去查询数据,会发现数据已经不存在。
5.1.2.过期策略
那么问题来了:
- Redis 如何判断一个 KEY 是否过期呢?
- Redis 又是何时删除过期 KEY 的呢?
Redis 不管有多少种数据类型,本质是一个 KEY-VALUE 的键值型数据库,而这种键值映射底层正式基于 HashTable 来实现的,在 Redis 中叫做 Dict.
来看下 RedisDB 的底层源码:
typedef struct redisDb {
    dict _dict;                 /_ The keyspace for this DB , 也就是存放KEY和VALUE的哈希表*/
    dict *expires;              /* 同样是哈希表,但保存的是设置了TTL的KEY,及其到期时间*/
    dict *blocking_keys;        /* Keys with clients waiting for data (BLPOP)*/
    dict *ready_keys;           /* Blocked keys that received a PUSH */
    dict *watched_keys;         /* WATCHED keys for MULTI/EXEC CAS _/
__    int id;                     /_ Database ID, 0 ~ 15 _/
__    long long avg_ttl;          /_ Average TTL, just for stats _/
__    unsigned long expires_cursor; /_ Cursor of the active expire cycle. */
    list *defrag_later;         /* List of key names to attempt to defrag one by one, gradually. */
} redisDb;
现在回答第一个问题:
Redis 是何时删除过期 KEY 的呢?
Redis 并不会在 KEY 过期时立刻删除 KEY,因为要实现这样的效果就必须给每一个过期的 KEY 设置时钟,并监控这些 KEY 的过期状态。无论对 CPU 还是内存都会带来极大的负担。
Redis 的过期 KEY 删除策略有两种:
- 惰性删除
- 周期删除
惰性删除,顾明思议就是过期后不会立刻删除。那在什么时候删除呢?
Redis 会在每次访问 KEY 的时候判断当前 KEY 有没有设置过期时间,如果有,过期时间是否已经到期。对应的源码如下:
// db.c
// 寻找要执行写操作的key
robj *lookupKeyWriteWithFlags(redisDb *db, robj *key, int flags) {
    // 检查key是否过期,如果过期则删除
    expireIfNeeded(db,key);
    return lookupKey(db,key,flags);
}

// 寻找要执行读操作的key
robj *lookupKeyReadWithFlags(redisDb *db, robj *key, int flags) {
    robj *val;
    // 检查key是否过期,如果过期则删除
    if (expireIfNeeded(db,key) == 1) {
        // 略 ...
    }
    val = lookupKey(db,key,flags);
    if (val == NULL)
        goto keymiss;
    server.stat_keyspace_hits++;
    return val;
}
周期删除:顾明思议是通过一个定时任务,周期性的抽样部分过期的 key,然后执行删除。
执行周期有两种:
- **SLOW 模式:**Redis 会设置一个定时任务
serverCron(),按照server.hz的频率来执行过期 key 清理 - **FAST 模式:**Redis 的每个事件循环前执行过期 key 清理(事件循环就是 NIO 事件处理的循环)。
SLOW 模式规则:
- ① 执行频率受
server.hz影响,默认为 10,即每秒执行 10 次,每个执行周期 100ms。 - ② 执行清理耗时不超过一次执行周期的 25%,即 25ms.
- ③ 逐个遍历 db,逐个遍历 db 中的 bucket,抽取 20 个 key 判断是否过期
- ④ 如果没达到时间上限(25ms)并且过期 key 比例大于 10%,再进行一次抽样,否则结束
FAST 模式规则(过期 key 比例小于 10% 不执行):
- ① 执行频率受
beforeSleep()调用频率影响,但两次 FAST 模式间隔不低于 2ms - ② 执行清理耗时不超过 1ms
- ③ 逐个遍历 db,逐个遍历 db 中的 bucket,抽取 20 个 key 判断是否过期
- ④ 如果没达到时间上限(1ms)并且过期 key 比例大于 10%,再进行一次抽样,否则结束
5.2.内存淘汰策略
对于某些特别依赖于 Redis 的项目而言,仅仅依靠过期 KEY 清理是不够的,内存可能很快就达到上限。因此 Redis 允许设置内存告警阈值,当内存使用达到阈值时就会主动挑选部分 KEY 删除以释放更多内存。这叫做内存淘汰机制。
5.2.1.内存淘汰时机
那么问题来了,当内存达到阈值时执行内存淘汰,但问题是 Redis 什么时候会执去判断内存是否达到预警呢?
Redis 每次执行任何命令时,都会判断内存是否达到阈值:
// server.c中处理命令的部分源码
int processCommand(client *c) {
    // ... 略
    if (server.maxmemory && !server.lua_timedout) {
        // 调用performEvictions()方法尝试进行内存淘汰
        int out_of_memory = (performEvictions() == EVICT_FAIL);
        // ... 略
        if (out_of_memory && reject_cmd_on_oom) {
            // 如果内存依然不足,直接拒绝命令
            rejectCommand(c, shared.oomerr);
            return C_OK;
        }
    }
}
5.2.2.淘汰策略
好了,知道什么时候尝试淘汰了,那具体 Redis 是如何判断该淘汰哪些 Key 的呢?
Redis 支持 8 种不同的内存淘汰策略:
noeviction: 不淘汰任何 key,但是内存满时不允许写入新数据,默认就是这种策略。volatile-ttl: 对设置了 TTL 的 key,比较 key 的剩余 TTL 值,TTL 越小越先被淘汰allkeys-random:对全体 key ,随机进行淘汰。也就是直接从 db->dict 中随机挑选volatile-random:对设置了 TTL 的 key ,随机进行淘汰。也就是从 db->expires 中随机挑选。allkeys-lru: 对全体 key,基于 LRU 算法进行淘汰volatile-lru: 对设置了 TTL 的 key,基于 LRU 算法进行淘汰allkeys-lfu: 对全体 key,基于 LFU 算法进行淘汰volatile-lfu: 对设置了 TTL 的 key,基于 LFI 算法进行淘汰
比较容易混淆的有两个算法:
- LRU(L
eastRecentlyUsed),最近最久未使用。用当前时间减去最后一次访问时间,这个值越大则淘汰优先级越高。 - LFU(L
eastFrequentlyUsed),最少频率使用。会统计每个 key 的访问频率,值越小淘汰优先级越高。
Redis 怎么知道某个 KEY 的 最近一次访问时间 或者是 访问频率 呢?
还记不记得之前讲过的 RedisObject 的结构?
回忆一下:

其中的 lru 就是记录最近一次访问时间和访问频率的。当然,你选择 LRU 和 LFU 时的记录方式不同:
- LRU:以秒为单位记录最近一次访问时间,长度 24bit
- LFU:高 16 位以分钟为单位记录最近一次访问时间,低 8 位记录逻辑访问次数
时间就不说了,那么逻辑访问次数又是怎么回事呢?8 位无符号数字最大才 255,访问次数超过 255 怎么办?
这就要聊起 Redis 的逻辑访问次数算法了,LFU 的访问次数之所以叫做逻辑访问次数,是因为并不是每次 key 被访问都计数,而是通过运算:
- ① 生成
[0,1)之间的随机数R - ② 计算
1/(旧次数 * lfu_log_factor + 1),记录为P,lfu_log_factor默认为 10 - ③ 如果
R<P,则计数器+1,且最大不超过 255 - ④ 访问次数会随时间衰减,距离上一次访问时间每隔
lfu_decay_time分钟(默认 1) ,计数器-1
显然 LFU 的基于访问频率的统计更符合我们的淘汰目标,因此官方推荐使用 LFU 算法。
算法我们弄明白了,不过这里大家要注意一下:Redis 中的 KEY 可能有数百万甚至更多,每个 KEY 都有自己访问时间或者逻辑访问次数。我们要找出时间最早的或者访问次数最小的,难道要把 Redis 中所有数据排序?
要知道 Redis 的内存淘汰是在每次执行命令时处理的。如果每次执行命令都先对全量数据做内存排序,那命令的执行时长肯定会非常长,这是不现实的。
所以 Redis 采取的是抽样法,即每次抽样一定数量(maxmemory_smples)的 key,然后基于内存策略做排序,找出淘汰优先级最高的,删除这个 key。这就导致 Redis 的算法并不是真正的 LRU,而是一种基于抽样的近似 LRU 算法。
不过,在 Redis3.0 以后改进了这个算法,引入了一个淘汰候选池,抽样的 key 要与候选池中的 key 比较淘汰优先级,优先级更高的才会被放入候选池。然后在候选池中找出优先级最高的淘汰掉,这就使算法的结果更接近与真正的 LRU 算法了。特别是在抽样值较高的情况下(例如 10),可以达到与真正的 LRU 接近的效果。
这也是官方给出的真正 LRU 与近似 LRU 的结果对比:
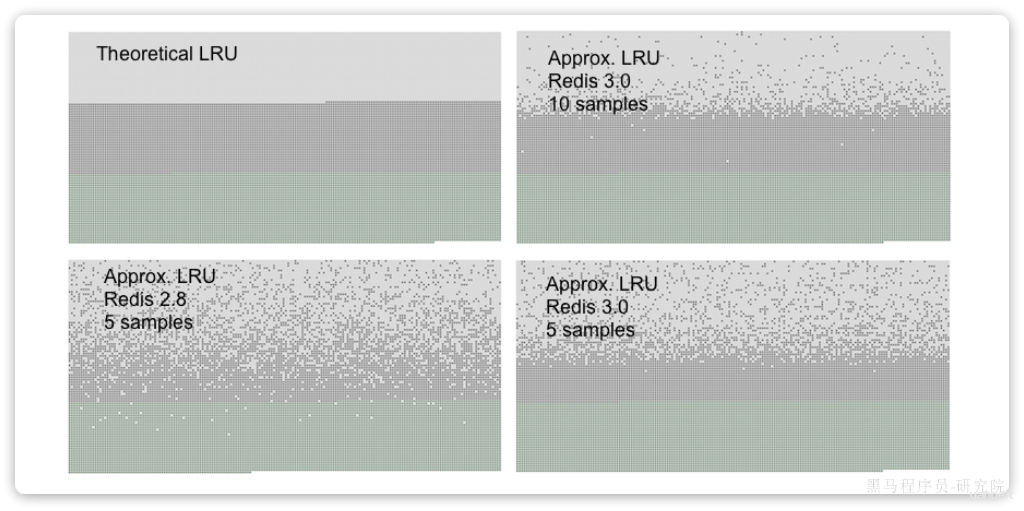
你可以在图表中看到三种颜色的点形成三个不同的带,每个点就是一个加入的 KEY。
- 浅灰色带是被驱逐的对象
- 灰色带是没有被驱逐的对象
- 绿色带是被添加的对象
5.3.总结
6.缓存问题
Redis 经常被用作缓存,而缓存在使用的过程中存在很多问题需要解决。例如:
- 缓存的数据一致性问题
- 缓存击穿
- 缓存穿透
- 缓存雪崩
6.1.缓存一致性
我们先看下目前企业用的最多的缓存模型。缓存的通用模型有三种:
Cache Aside:有缓存调用者自己维护数据库与缓存的一致性。即:- 查询时:命中则直接返回,未命中则查询数据库并写入缓存
- 更新时:更新数据库并删除缓存,查询时自然会更新缓存
Read/Write Through:数据库自己维护一份缓存,底层实现对调用者透明。底层实现:- 查询时:命中则直接返回,未命中则查询数据库并写入缓存
- 更新时:判断缓存是否存在,不存在直接更新数据库。存在则更新缓存,同步更新数据库
Write Behind Cahing:读写操作都直接操作缓存,由线程异步的将缓存数据同步到数据库
目前企业中使用最多的就是 Cache Aside 模式,因为实现起来非常简单。但缺点也很明显,就是无法保证数据库与缓存的强一致性。为什么呢?我们一起来分析一下。
Cache Aside 的写操作是要在更新数据库的同时删除缓存,那为什么不选择更新数据库的同时更新缓存,而是删除呢?
原因很简单,假如一段时间内无人查询,但是有多次更新,那这些更新都属于无效更新。采用删除方案也就是延迟更新,什么时候有人查询了,什么时候更新。
那到底是先更新数据库再删除缓存,还是先删除缓存再更新数据库呢?
现在假设有两个线程,一个来更新数据,一个来查询数据。我们分别分析两种策略的表现。
我们先分析策略 1,先更新数据库再删除缓存:
正常情况
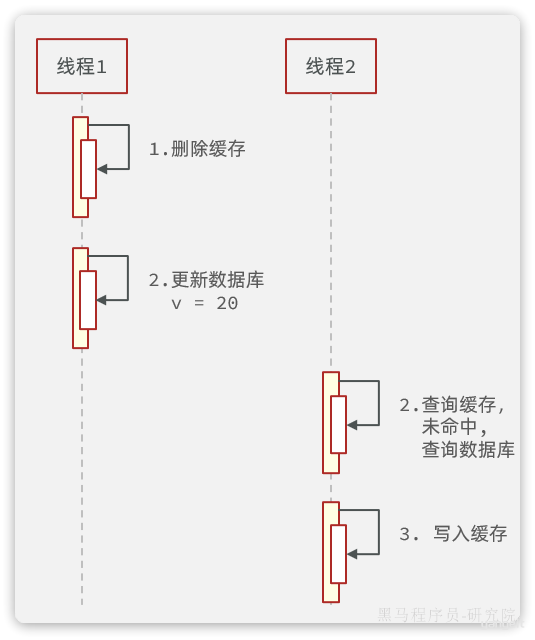
异常情况
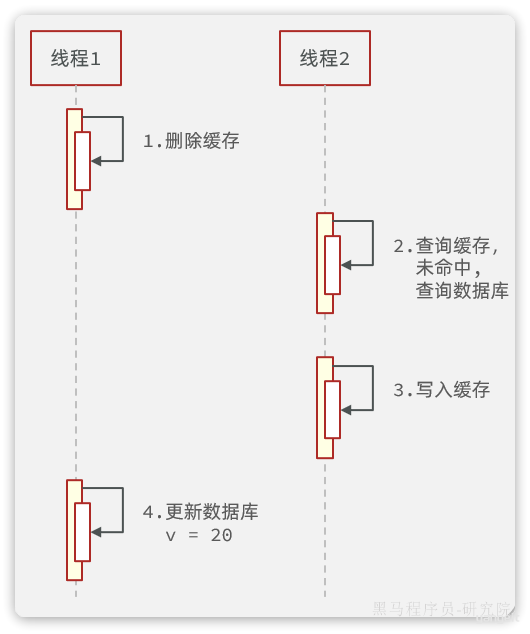
异常情况说明:
- 线程 1 删除缓存后,还没来得及更新数据库,
- 此时线程 2 来查询,发现缓存未命中,于是查询数据库,写入缓存。由于此时数据库尚未更新,查询的是旧数据。也就是说刚才的删除白删了,缓存又变成旧数据了。
- 然后线程 1 更新数据库,此时数据库是新数据,缓存是旧数据
由于更新数据库的操作本身比较耗时,在期间有线程来查询数据库并更新缓存的概率非常高。因此不推荐这种方案。
再来看策略 2,先更新数据库再删除缓存:
正常情况
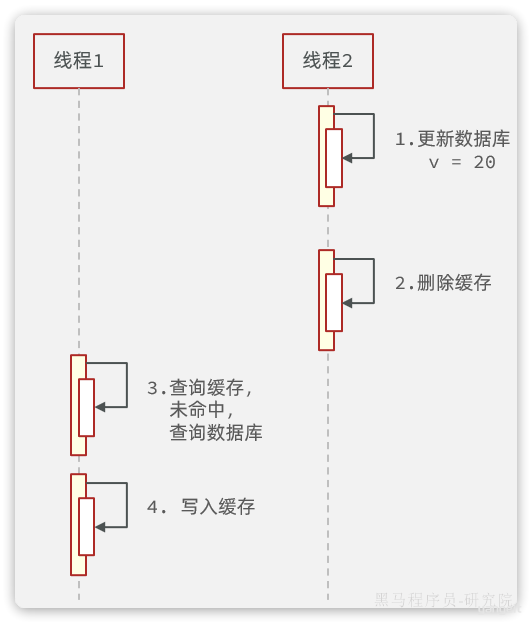
异常情况
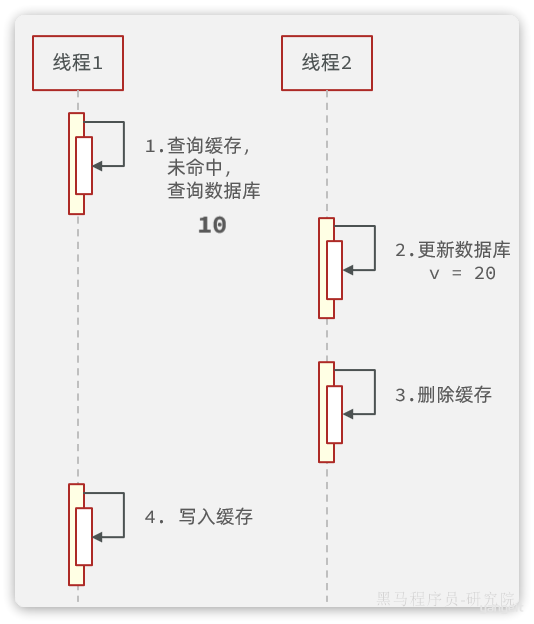
异常情况说明:
- 线程 1 查询缓存未命中,于是去查询数据库,查询到旧数据
- 线程 1 将数据写入缓存之前,线程 2 来了,更新数据库,删除缓存
- 线程 1 执行写入缓存的操作,写入旧数据
可以发现,异常状态发生的概率极为苛刻,线程 1 必须是查询数据库已经完成,但是缓存尚未写入之前。线程 2 要完成更新数据库同时删除缓存的两个操作。要知道线程 1 执行写缓存的速度在毫秒之间,速度非常快,在这么短的时间要完成数据库和缓存的操作,概率非常之低。
6.2.缓存穿透
什么是缓存穿透呢?
我们知道,当请求查询缓存未命中时,需要查询数据库以加载缓存。但是大家思考一下这样的场景:
如果我访问一个数据库中也不存在的数据。会出现什么现象?
由于数据库中不存在该数据,那么缓存中肯定也不存在。因此不管请求该数据多少次,缓存永远不可能建立,请求永远会直达数据库。
假如有不怀好意的人,开启很多线程频繁的访问一个数据库中也不存在的数据。由于缓存不可能生效,那么所有的请求都访问数据库,可能就会导致数据库因过高的压力而宕机。
解决这个问题有两种思路:
- 缓存空值
- 布隆过滤器
6.2.1.缓存空值
简单来说,就是当我们发现请求的数据即不存在与缓存,也不存在与数据库时,将空值缓存到 Redis,避免频繁查询数据库。实现思路如下:
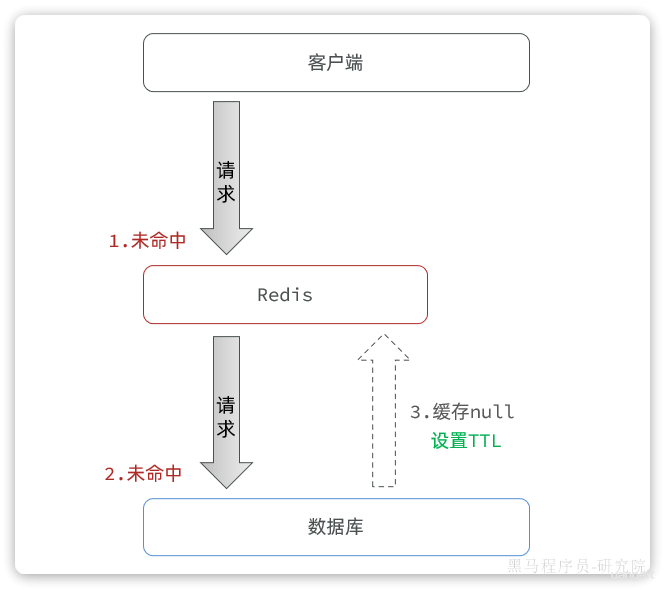
优点:
- 实现简单,维护方便
缺点:
- 额外的内存消耗
6.2.2.布隆过滤器
布隆过滤是一种数据统计的算法,用于检索一个元素是否存在一个集合中。
一般我们判断集合中是否存在元素,都会先把元素保存到类似于树、哈希表等数据结构中,然后利用这些结构查询效率高的特点来快速匹配判断。但是随着元素数量越来越多,这种模式对内存的占用也越来越大,检索的速度也会越来越慢。而布隆过滤的内存占用小,查询效率却很高。
布隆过滤首先需要一个很长的 bit 数组,默认数组中每一位都是 0.
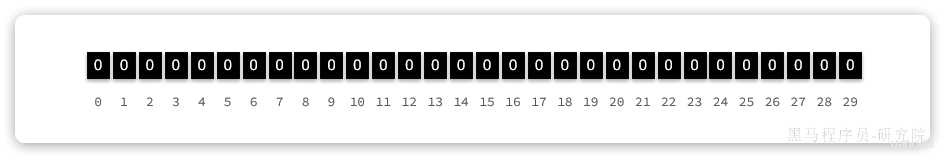
然后还需要 K 个 hash 函数,将元素基于这些 hash 函数做运算的结果映射到 bit 数组的不同位置,并将这些位置置为 1,例如现在 k=3:
hello经过运算得到 3 个角标:1、5、12world经过运算得到 3 个角标:8、17、21java经过运算得到 3 个角标:17、25、28
则需要将每个元素对应角标位置置为 1:
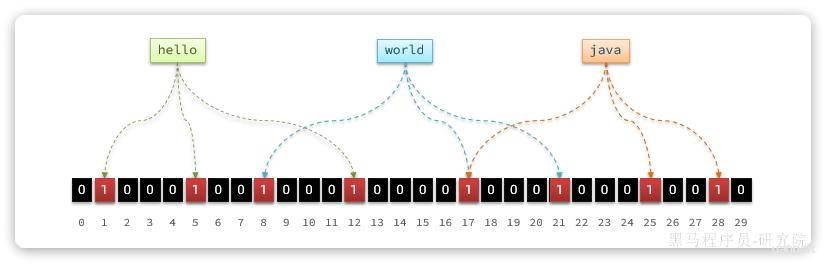
此时,我们要判断元素是否存在,只需要再次基于 K 个 hash 函数做运算, 得到 K 个角标,判断每个角标的位置是不是 1:
- 只要全是 1,就证明元素存在
- 任意位置为 0,就证明元素一定不存在
假如某个元素本身并不存在,也没添加到布隆过滤器过。但是由于存在 hash 碰撞的可能性,这就会出现这个元素计算出的角标已经被其它元素置为 1 的情况。那么这个元素也会被误判为已经存在。
因此,布隆过滤器的判断存在误差:
- 当布隆过滤器认为元素不存在时,它肯定不存在
- 当布隆过滤器认为元素存在时,它可能存在,也可能不存在
当 bit 数组越大、Hash 函数 K 越复杂,K 越大时,这个误判的概率也就越低。由于采用 bit 数组来标示数据,即便 4,294,967,296 个 bit 位,也只占 512mb 的空间
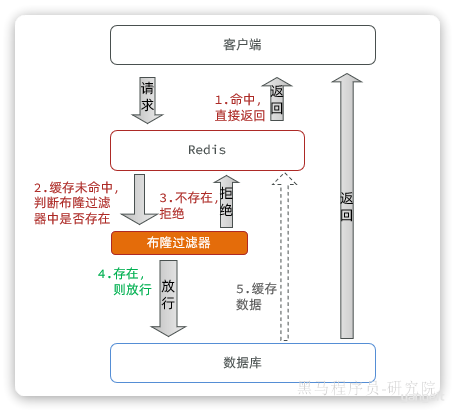
我们可以把数据库中的数据利用布隆过滤器标记出来,当用户请求缓存未命中时,先基于布隆过滤器判断。如果不存在则直接拒绝请求,存在则去查询数据库。尽管布隆过滤存在误差,但一般都在 0.01% 左右,可以大大减少数据库压力。
使用布隆过滤后的流程如下:
6.3.缓存雪崩
缓存雪崩是指在同一时段大量的缓存 key 同时失效或者 Redis 服务宕机,导致大量请求到达数据库,带来巨大压力。
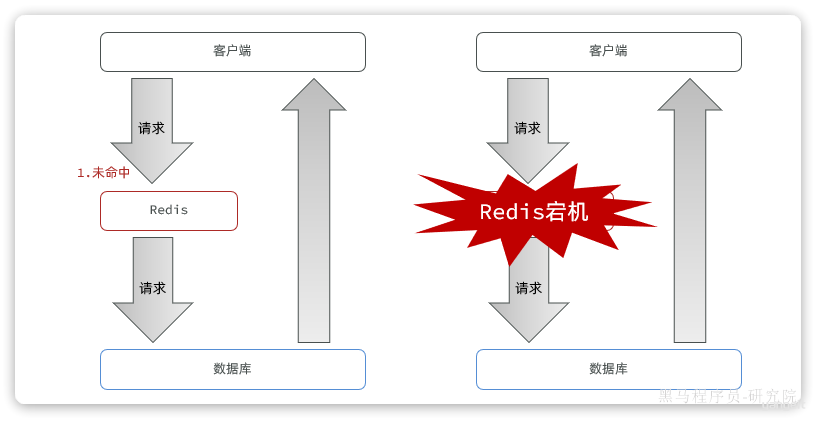
常见的解决方案有:
- 给不同的 Key 的 TTL 添加随机值,这样 KEY 的过期时间不同,不会大量 KEY 同时过期
- 利用 Redis 集群提高服务的可用性,避免缓存服务宕机
- 给缓存业务添加降级限流策略
- 给业务添加多级缓存,比如先查询本地缓存,本地缓存未命中再查询 Redis,Redis 未命中再查询数据库。即便 Redis 宕机,也还有本地缓存可以抗压力
6.4.缓存击穿
缓存击穿问题也叫热点 Key 问题,就是一个被高并发访问并且缓存重建业务较复杂的 key 突然失效了,无数的请求访问会在瞬间给数据库带来巨大的冲击。
由于我们采用的是 Cache Aside 模式,当缓存失效时需要下次查询时才会更新缓存。当某个 key 缓存失效时,如果这个 key 是热点 key,并发访问量比较高。就会在一瞬间涌入大量请求,都发现缓存未命中,于是都会去查询数据库,尝试重建缓存。可能一瞬间就把数据库压垮了。
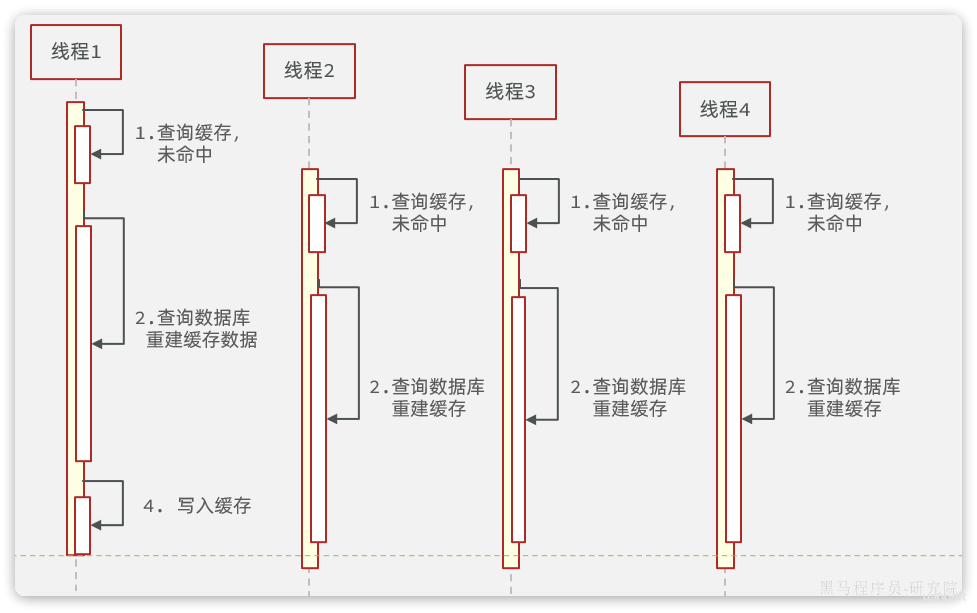
如上图所示:
- 线程 1 发现缓存未命中,准备查询数据库,重建缓存,但是因为数据比较复杂,导致查询数据库耗时较久
- 在这个过程中,一下次来了 3 个新的线程,就都会发现缓存未命中,都去查询数据库
- 数据库压力激增
常见的解决方案有两种:
- 互斥锁:给重建缓存逻辑加锁,避免多线程同时指向
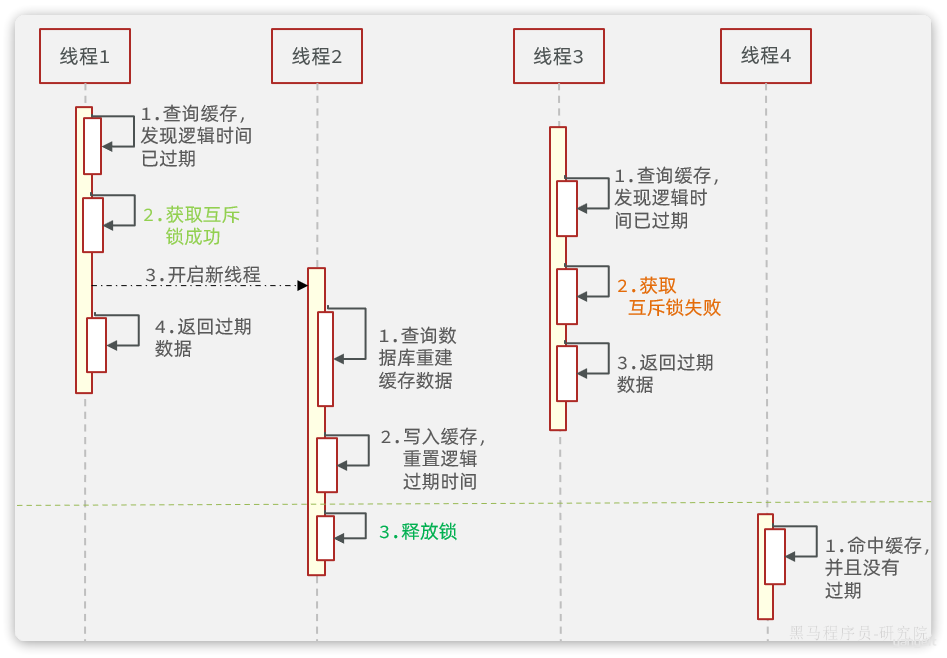
- 逻辑过期:热点 key 不要设置过期时间,在活动结束后手动删除。
基于互斥锁的方案如图:

逻辑过期的思路如图: